
· 15 мин. чтения
Google AI Mode выбирает не тех, кто в топе: мы собрали ответы Gemini через A-Parser
1. Почему обычный SERP-парсинг не показывает Google AI Mode
Обычный SERP-парсер показывает позиции, сниппеты и специальные блоки на странице Google. Этого достаточно, чтобы измерять привычную выдачу, но недостаточно для Google AI Mode.
В AI Mode пользователь получает развёрнутый ответ Gemini и набор связанных источников. Позиция сайта в обычном топ-10 отвечает только на один вопрос: насколько высоко страница расположена в классической выдаче. Она не показывает, появится ли сайт среди источников AI Mode, назовёт ли Gemini бренд или отправит пользователя на другой ресурс.
Например, страница может занимать первое место по запросу, а AI Mode в качестве источника показать независимый обзор, ролик на YouTube или обсуждение на Reddit. Поэтому для AI Mode нужно отдельно собирать сам ответ и страницы, на которые он ссылается.
| Обычная выдача Google | Google AI Mode |
|---|---|
| Позиции, сниппеты и специальные блоки | Развёрнутый ответ Gemini и связанные источники |
| Топ-10 органических URL | Набор страниц, выбранных для конкретного ответа |
| Одна страница результатов | Диалог с возможными уточняющими вопросами |
Для SEO-команды это меняет задачу мониторинга. Нужно видеть не только позицию сайта, но и то, упоминает ли Gemini бренд, какие страницы использует как источники и как ответ меняется между языковыми и региональными срезами.
В бенчмарке Ahrefs [1] источники AI Overviews и AI Mode пересекались на 13,7%, хотя ответы совпадали по смыслу в 86% случаев. Близкие по смыслу ответы могут опираться на разные страницы.
В этой статье мы показываем работу  FreeAI::GoogleAI в A-Parser: что возвращает парсер, как выглядят логи и как настроить мониторинг на своих запросах.
Область эксперимента: ниже рассматривается Google AI Mode. AI Overviews в этот материал не входят.
2. Что внутри диалогового поиска: пять ключевых закономерностей выдачи Gemini
Для чистоты эксперимента мы взяли 10 запросов, отражающих реальные технические боли оптимизаторов, и спарсили полные диалоги Google AI Mode в двух языковых средах (hl=en и hl=ru) через встроенный парсер FreeAI::GoogleAI на пуле резидентных прокси.
Полученные результаты наглядно показывают ключевые особенности структуры выдачи:
Суммарные метрики нашего экспериментального среза:
• Выполнено запросов: 10 из 10 в обеих локалях (ошибок: 0)
• Собрано источников цитирования: 141 ссылка (86 в EN, 55 в RU), из них 109 уникальных доменов (64 в EN, 45 в RU)
• Объем сырых структурированных ответов: 82 118 символов
• Время выполнения задачи: 3–4 минуты2.1. Механика удержания: встречные вопросы и квалификация пользователя
В классическом поиске Google отдавал вам ссылки и «отпускал» на внешний сайт. В Google AI Mode алгоритм стремится удержать пользователя внутри интерфейса.
В каждом ответе модель в финале формирует многошаговые интерактивные ветки со встречными вопросами (follow-ups). Вот дословные фрагменты из полученных логов:
Запрос: “best cheaper ahrefs alternatives in 2026” Ответ Gemini (сырой лог): «…If you want to narrow down your choice, tell me:
- What is your monthly budget?
- What is your core focus (backlinks, keyword research, or rank tracking)? I can recommend the exact platform and plan tier that fits your workflow.»
Запрос: “помогает ли микроразметка schema для ранжирования в gemini” Ответ Gemini (сырой лог): «…Для более точной рекомендации подскажите:
- Какая тематика у вашего сайта (интернет-магазин, блог, локальный бизнес, медиа)?
- Какие типы Schema.org вы планируете внедрить или уже используете? Я подскажу, как правильно оформить данные для ИИ-ботов.»
Gemini перехватывает роль квалифицирующего лид-менеджера: он сам сегментирует посетителя по бюджету, нише и техническому стеку. Пользователю больше незачем серфить сайты вендоров — он продолжает общаться с консультантом внутри Google.
2.2. Разрыв цитирования: упоминания брендов без кликабельных ссылок
Один из самых показательных выводов среза — разрыв между упоминанием бренда в синтезированном тексте и фактической ссылкой на него в блоке цитат:
| Бренд / Инструмент | Упоминаний в тексте Gemini (EN + RU) | Ссылок на официальный домен (из 141 строки источников) |
|---|---|---|
| Ahrefs | 27 раз | 0 ссылок (0%) |
| SE Ranking | 25 раз | 0 ссылок (0%) |
| Semrush | 24 раза | 1 ссылка (0,7%) |
| Screaming Frog | 17 раз | 0 ссылок (0%) |
| Sitebulb | 11 раз | 1 ссылка (0,7%) |
| Moz | 2 раза | 0 ссылок (0%) |
Нейросеть прекрасно знает о существовании лидеров рынка из своей базовой модели обучения. Но когда дело доходит до формирования блока подтверждающих источников (sources), Google AI Mode ссылается не на сайты лидеров, а на:
- Нишевые блоги и микроагентства (
onelittleweb.com,artrix.ru,clickrank.ai,contextbolt.com); - Платформы пользовательского опыта (Reddit, LinkedIn, Habr);
- Видеоролики на YouTube.
Отдельный анализ Ahrefs по 31 тыс. упоминаний собственного бренда на шести AI-платформах показывает похожую проблему: ссылки сопровождали упоминание Ahrefs в 36,8% случаев в AI Mode и примерно в 28% в среднем по всем платформам исследования [2].
Наши замеры наглядно подтверждают этот разрыв на практике: Ahrefs (27 упоминаний в тексте) и Screaming Frog (17 упоминаний) получили ровно 0 ссылок на свои официальные домены в блоке подтверждающих источников. Нейросеть прекрасно знает лидеров рынка, но кликабельный трафик распределяет между независимыми обзорами, форумами и сообществами.
2.3. YouTube: AI Mode может сослаться на конкретный момент ролика
Что в данных: в англоязычном срезе YouTube появился в 7 из 86 источников. В одном из ответов AI Mode не просто показал ролик, а вывел точку входа — 6:03:
Watch this helpful guide on navigating AI citations: 6:03 How to Rank in Google’s AI Overviews The New Citation Strategy.
Это не абстрактная рекомендация «посмотрите YouTube», а ссылка на фрагмент, который система сочла релевантным конкретному вопросу.
Что делать: хранить запрос, возвращённый URL, домен и сниппет. Если во сниппете есть таймкод, сохранять и его. Базовая выгрузка не даёт отдельного поля канала или заголовка ролика: эти данные имеет смысл добавлять отдельным этапом только при необходимости.
2.4. /goto и неполные записи источников
Что в данных: Google AI Mode иногда не отдаёт глубокий URL источника. Вместо него s.link содержит корень домена, s.anchor — доменное имя, а в s.snippet попадает внутренний токен /goto. В одном из логов строка выглядит так:
SOURCE: https://www.reddit.com | reddit.com | /goto?url\u003dCAESkQEB6zswFVycSRp...То есть s.link вернул https://www.reddit.com, s.anchor — reddit.com, а s.snippet — /goto?url\u003dCAES... с нераскодированной последовательностью \u003d вместо =.
Как учитывать: домен из s.link и s.anchor пригоден для доменного отчёта, но корневой URL нельзя принимать за адрес исходной статьи или треда. Сохраняйте все три поля в сыром виде и считайте домены отдельно от глубоких URL.
2.5. Геозависимость: как IP-адрес прокси определяет состав сервисов
Мы проверили целевой набор из 10 русских SEO-запросов (список приведён ниже в шаге 4): собрали ответы сначала через американский резидентский пул (US), а затем через украинский (UA).
Результаты наглядно показали, как географическая точка выхода прокси фильтрует коммерческий контекст:
- US-прокси: локальные сервисы СНГ были представлены минимально (Keys.so встретился 1 раз, а Топвизор, Пиксель Тулс и Serpstat не упоминались вовсе). Модель в основном выдавала глобальные комбайны: SE Ranking (17), Ahrefs (16), Semrush (8).
- UA-прокси: состав локальных инструментов расширился — Serpstat (4), Keys.so (3), Топвизор (2), Пиксель Тулс (1), тогда как число упоминаний международного SE Ranking снизилось с 17 до 2.
| Инструмент / Сервис | Упоминаний через US-прокси (hl=ru) | Упоминаний через UA-прокси (hl=ru) | Изменение в выдаче |
|---|---|---|---|
| SE Ranking | 17 | 2 | Спад в 8.5 раз |
| Serpstat | 0 | 4 | Появился в топе |
| Keys.so | 1 | 3 | Рост в 3 раза |
| Топвизор | 0 | 2 | Появился в топе |
| Пиксель Тулс | 0 | 1 | Появился в топе |
Смена пула в этом контрольном срезе сопровождалась заметным изменением состава сервисов, но одного запуска на пул мало, чтобы отделить геолокацию от вариативности ответов Gemini: языковой параметр hl задает язык генерации, однако географическая точка выхода прокси способна смещать контекст рекомендуемых продуктов.
3. Как парсить Google AI Mode в A-Parser: пошаговое руководство
Встроенный парсер FreeAI::GoogleAI [3] в A-Parser решает главную проблему: он взаимодействует с диалоговым интерфейсом напрямую, имитируя поведение реального браузера, без необходимости покупать дорогостоящие токены API Google Gemini.
| Что на входе | Что на выходе |
|---|---|
| Список промптов в поле «Запросы» | Развернутый синтезированный ответ Gemini (p1.answer) |
| IP-адрес и геолокация прокси | Точный региональный срез выдачи и релевантные локальные бренды |
| Шаблон вывода (JSON / CSV) | Структурированный массив источников (s.link), доменов (s.anchor) и цитат (s.snippet) |
Шаг 1. Конфигурация парсера и среды
В диспетчере заданий A-Parser выберите встроенный парсер FreeAI::GoogleAI.
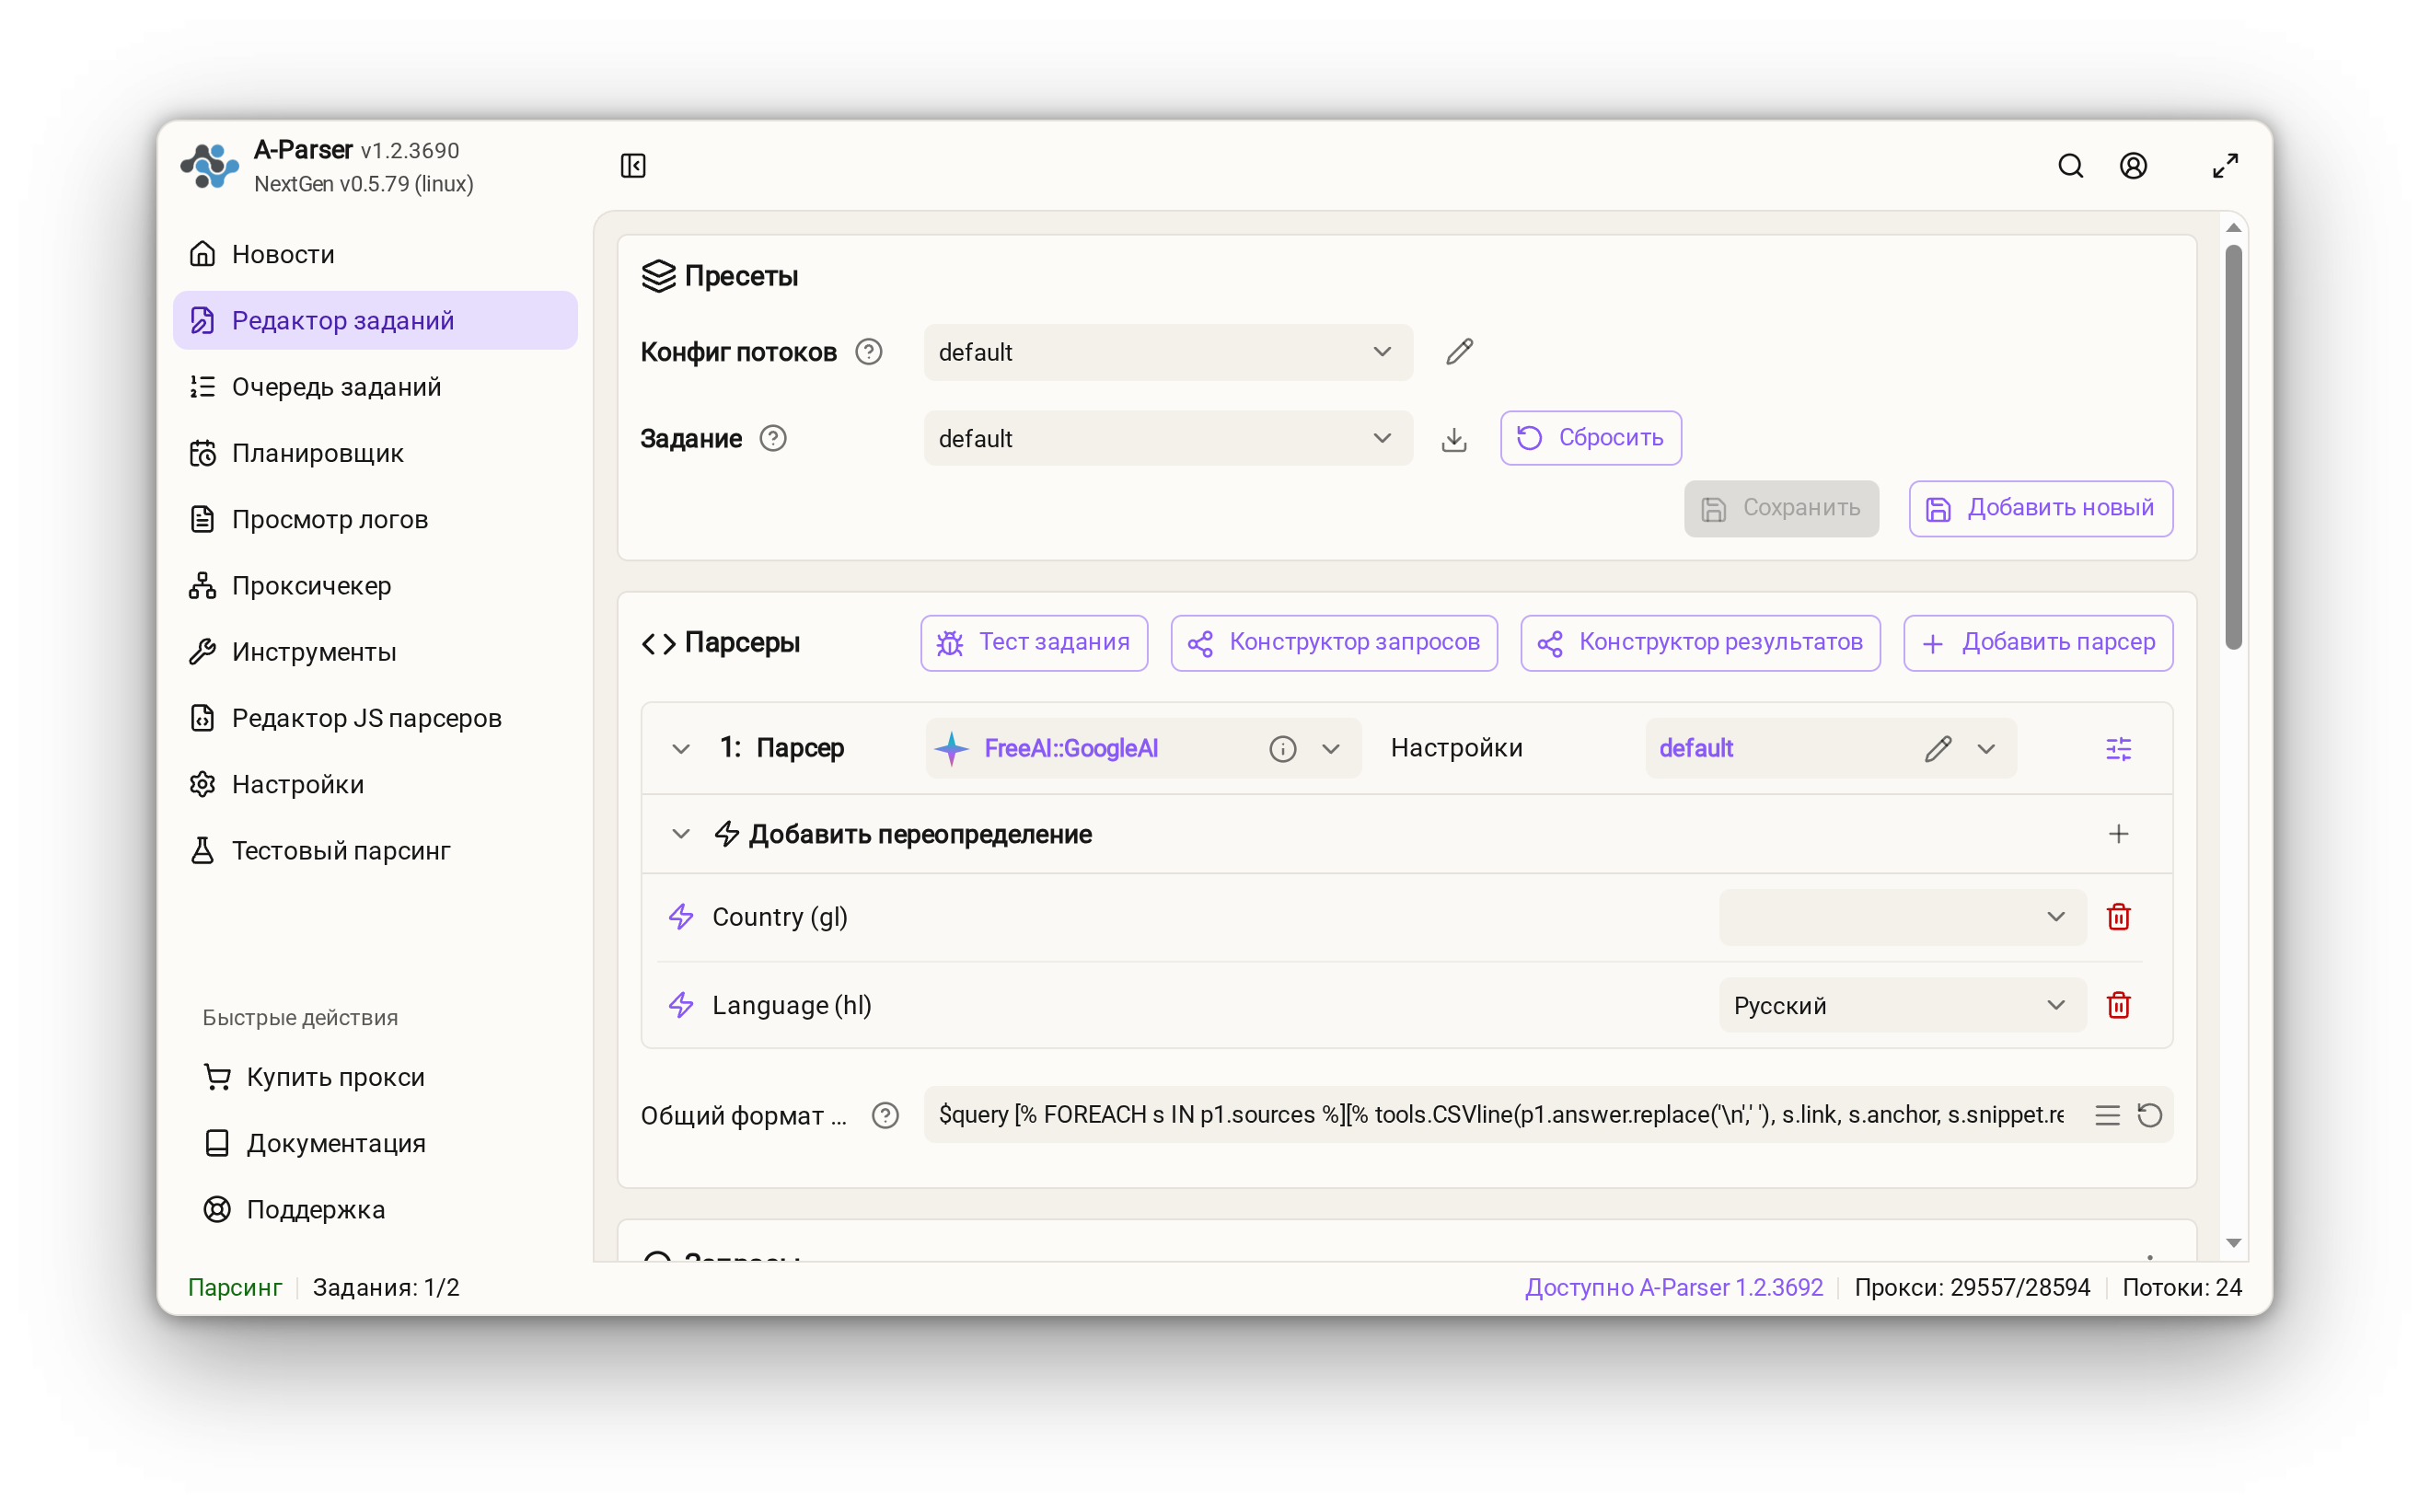
Базовые параметры настройки:
- Интерфейсный язык (
hl):en(для глобальной англоязычной выдачи) илиru(для русскоязычной). - Страна (
gl):Auto (Based on IP)— синхронизирует геолокацию выдачи с точкой выхода прокси.
Шаг 2. Подключение прокси и сетевые параметры
Google защищает диалоговый режим от автоматизированного доступа, поэтому использование серверных (датацентровых) IP недопустимо — они приводят к немедленной капче или пустым ответам.
- Тип прокси: Для старта мы использовали Premium-резидентные прокси A-Parser. Мобильные прокси могут быть альтернативой; ротацию настройте по запросу или по таймауту.
- Проверка пула: Валидация задержки и стабильности через встроенный проксичекер A-Parser.
- Число потоков: 3–5 потоков на старте (для планомерной эмуляции сессий без перегрузки).
- Таймаут запроса: 60 секунд (генерация связного ответа нейросетью занимает от 4 до 12 секунд).
Шаг 3. Настройка формата вывода (Template Toolkit)
Вся мощь A-Parser раскрывается в шаблонизаторе вывода. В отличие от закрытых сервисов, здесь мы получаем доступ к полной объектной модели ответа:
| Переменная | Назначение | Содержимое в реальном ответе |
|---|---|---|
p1.answer | Синтезированный ответ Gemini | Полный связный текст экспертной консультации |
p1.sources | Массив источников | Список всех подтверждающих веб-страниц и видео |
s.link | Прямой URL источника | Целевой адрес веб-страницы или видеохостинга |
s.anchor | Домен площадки | Чистое доменное имя сайта (reddit.com, youtube.com) |
s.snippet | Точная цитата | Текстовый фрагмент первоисточника, на который опирался алгоритм |
CSV для Excel и табличного анализа
Для первого запуска достаточно плоской CSV-выгрузки. Она сохраняет ответ Gemini и одну строку для каждого источника; файл можно открыть в Excel, Google Таблицах или затем загрузить в базу.
$query
[% FOREACH s IN p1.sources %]
[% tools.CSVline(p1.answer.replace('\n', ' '), s.link, s.anchor, s.snippet.replace('\n', ' ')) %]
[% END %]$query выводится отдельной строкой, а tools.CSVline формирует корректные колонки из ответа, URL, анкора и сниппета. JSON или JSON Lines лучше собирать отдельным шагом после выгрузки — это тема для отдельной инструкции.
Шаг 4. Разделяйте языковое и географическое сравнение
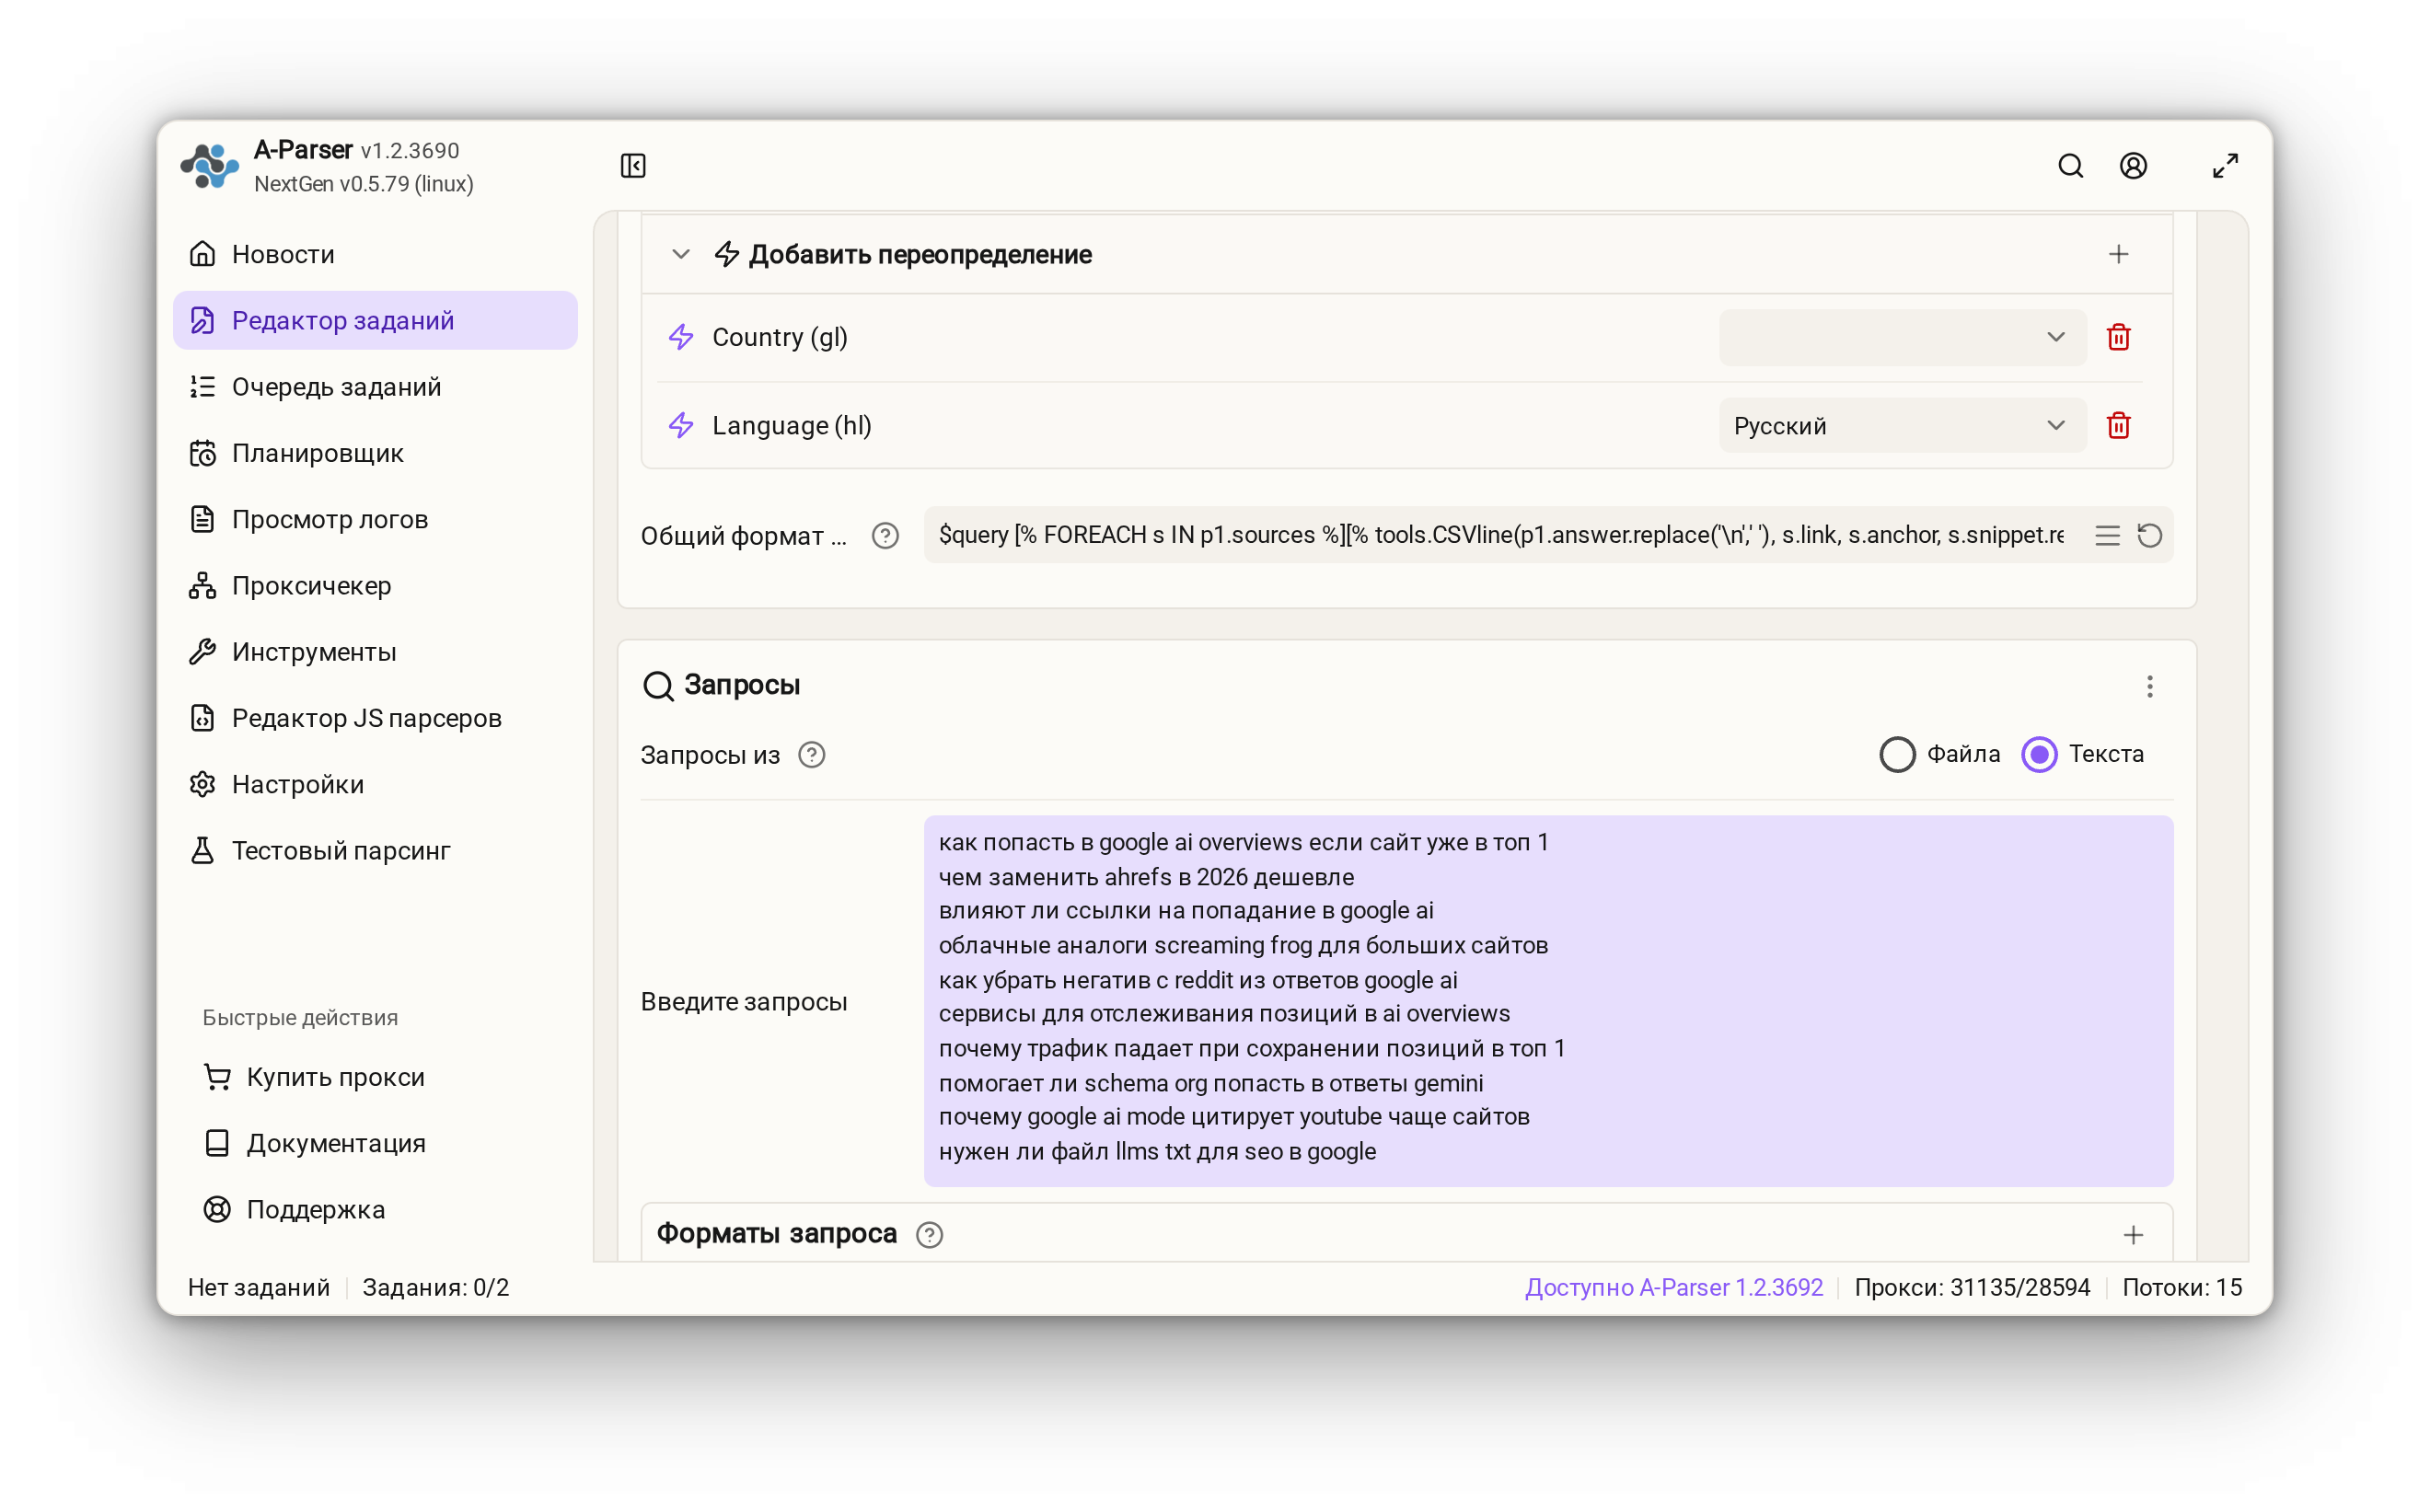
В этом примере мы использовали два тематически сопоставимых набора SEO-вопросов: один на русском, другой на английском. Так можно увидеть, как меняются ответы и источники вместе со сменой языка.
Пример русскоязычных запросов из контрольного среза
помогает ли микроразметка schema для ранжирования в gemini
помогает ли файл llms txt для seo в google
помогают ли обратные ссылки попасть в цитирование google ai
как убрать негативные обсуждения на reddit из выдачи google ai
облачные краулеры как замена screaming frog для больших сайтов
как попасть в цитирование google ai overviews при первом месте в выдаче
лучшие трекеры позиций для google ai overviews
лучшие недорогие альтернативы ahrefs в 2026 году
почему google ai mode ссылается на youtube вместо сайтов
почему падает органический трафик при первых позицияхПример англоязычных запросов из контрольного среза
how to get cited in google ai overviews when ranking #1
best cheaper ahrefs alternatives in 2026
do backlinks help you get cited in google ai
cloud crawler alternatives to screaming frog for large sites
how to remove negative reddit threads from google ai results
best rank trackers for google ai overviews
why organic traffic drops while rankings stay #1
does schema markup help rank in gemini search
why google ai mode cites youtube instead of websites
does llms txt help with google seoДля чистой проверки географии всё иначе: язык и набор вопросов нужно зафиксировать, а через разные прокси-пулы запускать один и тот же набор. Иначе вы не узнаете, вызвана ли разница языком или местоположением.
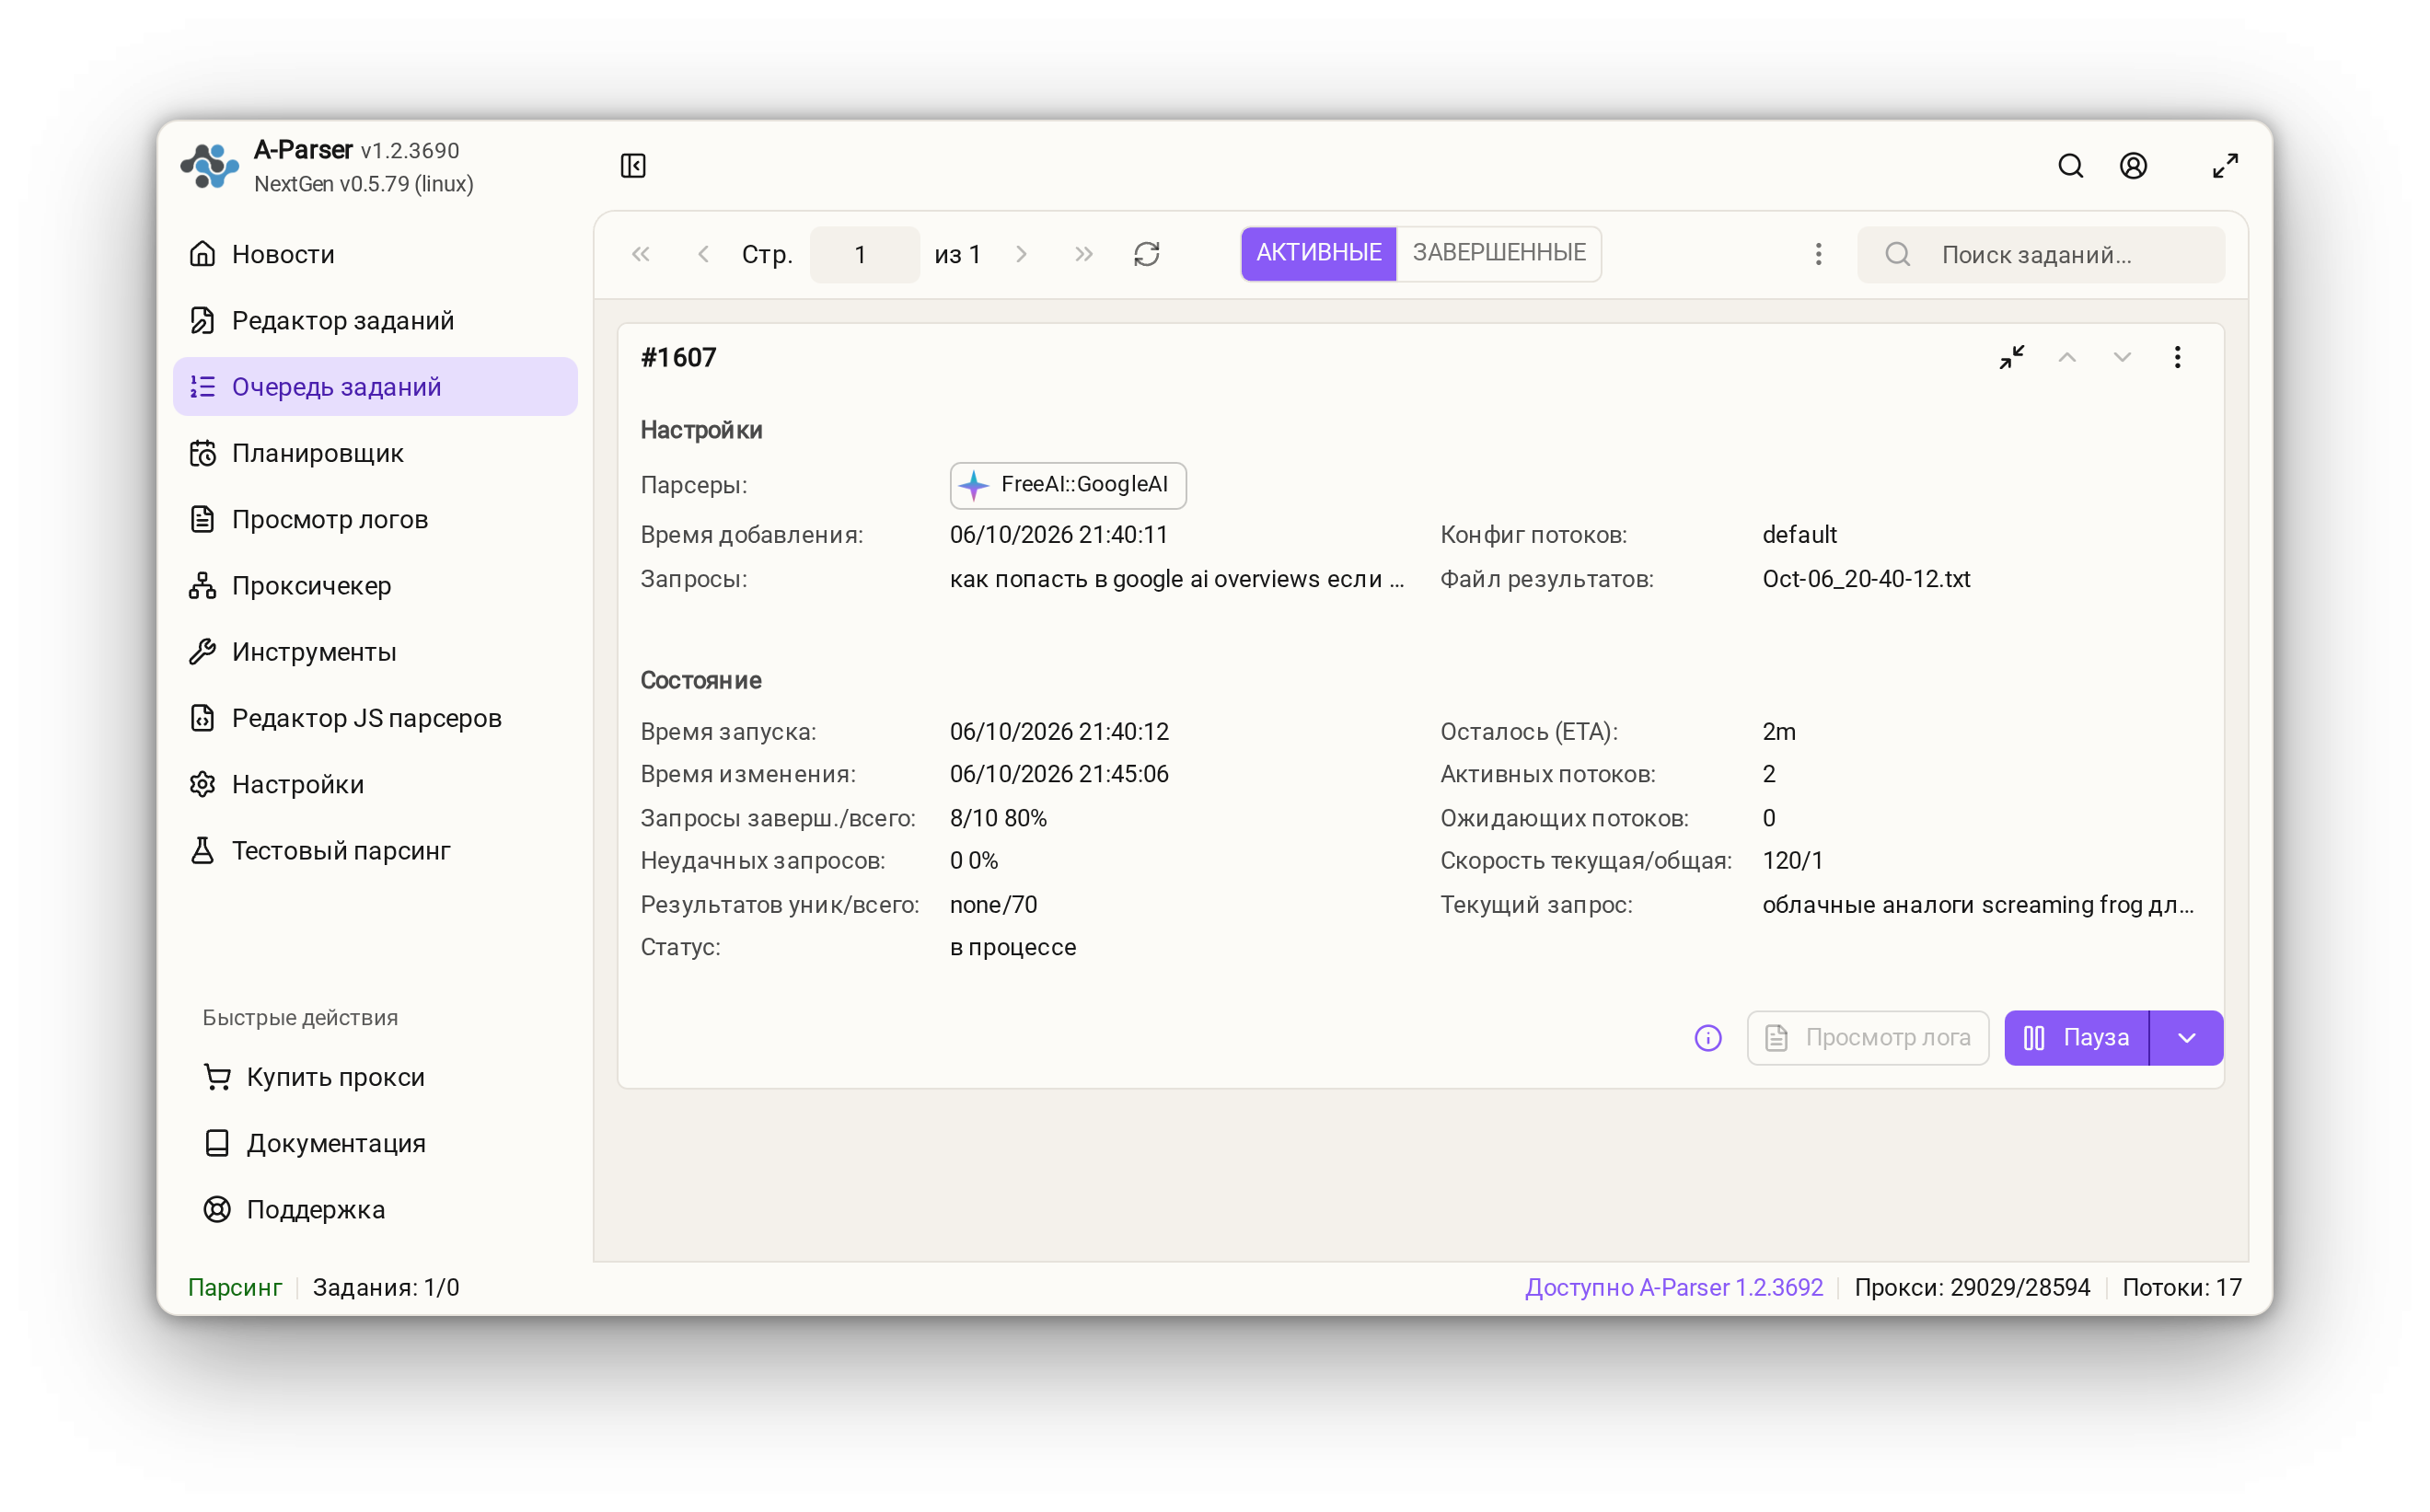
Сохранение результата и запуск
В разделе «Результаты» включите сохранение в файл и в поле «Имя файла» укажите, например:
google_ai_mode_$datefile.format().csvЕсли будете открывать выгрузку в Excel, включите «Записать UTF-8 BOM». Затем нажмите «Добавить задание» или «Запустить». После завершения скачайте CSV из очереди заданий.
Параметры сбора контрольного среза
| Параметр | Значение |
|---|---|
| Поисковая среда / Движок | Google AI Mode («Search with AI») |
| Версия A-Parser | v1.2.3690 (Linux) |
| Встроенный парсер | FreeAI::GoogleAI |
| Количество запросов | 10 исследовательских вопросов (в поле «Запросы», queriesFrom = text) |
| Геолокация и прокси | Резидентные прокси: пул США (hl=en) и пул СНГ (hl=ru) |
| Потоки и сетевой таймаут | 3 потока, таймаут 60 секунд |
| Формат результата | CSV через tools.CSVline |
| Результат выполнения | 20 из 20 сессий успешно (100% Success Rate), 0 капч и блокировок |
Сводные результаты запуска теста
| Показатель | Результат |
|---|---|
| Размер выборки | 10 запросов в 2 языковых средах (20 диалоговых сессий) |
| Собрано подтверждающих источников | 141 цитирование (86 в EN, 55 в RU); 109 уникальных доменов (64 в EN, 45 в RU) |
| Объем сырого текста | 82 118 символов экспертной аналитики |
| Время сбора данных | ~3.5 минуты на весь двухдиапазонный срез |
| Переменные расходы на сбор | < $0.05 (только сетевой трафик резидентных прокси) |
Источники с токеном /goto | 2.13% (3 из 141; отдан корень домена в s.link, токен в s.snippet) |
| YouTube в источниках | 6.4% цитат (9 из 141; 8.1% в EN-срезе); таймкоды внутри сниппета |
| Reddit в источниках | Топ-1 внешняя площадка (10 упоминаний) |
4. SaaS или собственный сбор: что выбрать для мониторинга AI Mode
К этому вопросу имеет смысл переходить после первого сбора: когда уже понятно, какие ответы, URL, анкоры и сниппеты нужны команде.
Сколько стоит регулярный мониторинг AI Mode
Ниже мы привели примеры публично доступных тарифов. Один отслеживаемый запрос в разных сервисах может подразумевать разные комбинации модели, страны и частоты проверки. Поэтому приведённые значения — не стоимость одного запуска, а ориентир для сравнения объёма запросов, включённых в тариф.
| Сервис | План и цена в месяц | Включено запросов | Цена за включённый запрос |
|---|---|---|---|
| Semrush AI Visibility | Toolkit — $99 | 25 | $3.96 |
| Peec AI | Starter — $95 | 50 | $1.90 |
| Peec AI | Advanced — $495 | 350 | $1.41 |
| OtterlyAI | Standard — $189 | 100 | $1.89 |
| OtterlyAI | Pro — $989 | 1 000 | $0.99 |
| A-Parser | Постоянная лицензия + прокси | В лицензии нет лимита запросов | Зависит от трафика и инфраструктуры |
Ни один публичный план в таблице не включает 2 000 отслеживаемых запросов. На таком объёме SaaS обычно требует дополнительной ёмкости или индивидуального тарифа; у A-Parser растут затраты на прокси и требования к производительности, а не число запросов. *Тарифы на сайтах сервисов могут меняться, поэтому перед покупкой рекомендуем самостоятельно проверять актуальные цены и условия.
Итог: когда A-Parser выгоднее
SaaS удобен, если нужно быстро открыть готовую панель для нескольких брендов и не настраивать сбор. Однако при регулярном отслеживании сотен или тысяч запросов A-Parser позволяет лучше контролировать расходы: лицензия не предполагает отдельной платы за добавление новых брендов, доменов или групп запросов.
Это не означает, что собственный сбор бесплатен: нужны лицензия, прокси и вычислительные ресурсы. Зато A-Parser позволяет сохранять полный текст ответов Gemini, URL, анкоры и сниппеты, выбирать свои вопросы и нужные географии, задавать правила подсчёта и хранить результаты в файлах или базе данных. Если AI Mode нужно отслеживать регулярно и по собственной методике, A-Parser выгоднее стандартного отчёта из готового сервиса.
5. От логов к действиям: что значат полученные данные для оптимизации
Если сопоставить результаты этого среза с практикой поисковой оптимизации, сырые логи показывают пять устойчивых закономерностей:
- Вендоры упоминаются текстом, а ссылки уходят сторонним ресурсам
Что в данных: Модель свободно называет бренды лидеров в тексте ответов, но в блоке источников (sources) прямых ссылок на их сайты практически нет — трафик забирают обзоры, каталоги и обсуждения.
Что делать: Не замыкаться только на ссылках на свой домен. Продвигать бренд через независимые отраслевые медиа, сравнения и профильные блоги: диалоговый поиск охотнее цитирует внешние подтверждения. - YouTube стал полноценным текстово-визуальным источником ответов
Что в данных: Видеохостинг занял 8,1% источников в англоязычном срезе и 6,4% во всей выборке; в одном из логов AI Mode вывел ролик с точным таймкодом внутри сниппета. Search Engine Journal встретился в нашем срезе один раз как источник. Отдельно SEJ пересказывает исследование SE Ranking: в нём Google составляет 17% всех цитат AI Mode, а вместе с YouTube — около 20% [4]. Это внешний агрегированный замер, а не показатель текущего среза и не утверждение Gemini.
Что делать: Готовить видеоконтент с субтитрами и разметкой глав (Chapters). Чётко структурированные ролики проще сопоставлять с вопросами аудитории и проверять в следующих срезах. - Reddit и сообщества напрямую формируют тональность ответов
Что в данных: Дискуссионные ветки регулярно цитируются для подтверждения пользовательского опыта, особенно в сравнительных запросах и вопросах о недостатках продуктов.
Что делать: Выстраивать работу с репутацией на открытых площадках. Если в популярном треде зафиксирован негатив, он транслируется в ответы ИИ без фильтрации. Закрывать такие претензии нужно непосредственно в обсуждениях. - Schema.org работает как фиксатор фактов против галлюцинаций
Что в данных: Модель склонна достраивать характеристики и цены по косвенным признакам, если на странице нет однозначной семантической структуры.
Что делать: Размечать ключевые сущности (Organization,Product,FAQPage). Разметка не дает гарантированного преимущества в ранжировании, но фиксирует точные атрибуты бизнеса и защищает от искажения фактов нейросетью. - Смена пула прокси сопровождается заметным сдвигом в составе сервисов
Что в данных: Смена точки выхода (US vs UA) в контрольном срезе сопровождалась перераспределением: спад международного SE Ranking с 17 до 2 и рост региональных игроков (Serpstat с 0 до 4, Keys.so с 1 до 3, Топвизор с 0 до 2, Пиксель Тулс с 0 до 1). При этом одного запуска на пул мало, чтобы надёжно отделить влияние геолокации от естественной вариативности ответов Gemini.
Что делать: Проводить замеры через пулы прокси целевого региона серией повторных запусков: одиночные ответы генеративных моделей подвержены стохастической вариативности.
6. Заключение
Главный вывод из нашего эксперимента прост: отслеживать только позиции в органическом топе в 2026 году уже недостаточно.
Пока Google Search Console показывает стабильное первое место, в Google AI Mode происходит реальный выбор: нейросеть напрямую отвечает пользователю, цитирует таймкоды роликов с YouTube, ссылается на треды Reddit и рекомендует альтернативные сервисы. Если вы не видите эти диалоги целиком, вы не контролируете реальный поисковый трафик.
SaaS-панель помогает быстро получить готовый отчёт, но её тариф и лимиты запросов нужно соотносить с объёмом регулярного мониторинга. Связка A-Parser и встроенного парсера FreeAI::GoogleAI позволяет развернуть автономный сбор на своём компьютере или сервере: получать полные тексты ответов Gemini и источники, а стоимость масштабирования оценивать через сервер, прокси и собственную инфраструктуру.
Полезные материалы
- FreeAI::GoogleAI — официальная документация, параметры и спецификация объектной модели ответа.
- Выбрать лицензию A-Parser (Pro или Enterprise) — постоянная лицензия без абонентской платы и ограничений по числу доменов.
- Подключить Premium-прокси A-Parser — чистые резидентные пулы с точной геолокацией для стабильного сбора генеративной выдачи.
Готовый пресет
В Редакторе заданий в строке Пресет задания (Task preset) нажмите кнопку импорта справа от поля и выберите Импорт пресета (Import preset). Разверните спойлер и вставьте Base64-код в поле импорта.
Показать код пресета для импорта
eJx9Vd9v2zgM/lcE3Ya2hyBYB9we8pZlza6HXrO12700RcHatK2LLGmiHDcI8r+P
kp047XX3kkgkP/74SMpbuUZPyho5OR/JALSiLx4JA8nJ3Va6dJYTmWMBjQ5yJB14
Ygir7+TcI04vJ5PP1paaT6w+GG5l2DhkqOUIXuXISpXzvdJ8WoNuohKN3P3atDw2
/T9D5+3TZlZhtkJ/BPld7u7vR5KL4JRobn0NsZg3Pxr0G3H3VswXNxfT2Z+CxOW1
cOdjso3PkMTbe1YGazWNZ7f/aGXwlLVgqEU/9ug0ZHh6slyak9GJODkbCRqz0Sr+
g8kq6+OJjHIOwyv2Z12Ai+tPfJCHBG9hjd8sJ1gojYN4zrdrqGNBZSL6AdRDbXN8
eJNDwGg8LlJtp2fjjNaMhDxXgbsKuis6tmsg4rtRPxI/xrJtJEMhzb2tWRTwKfTC
zZ6wu54xyS6ahP3aYeSkAE04ksSZz4ETyV9qVEAPwfqFi/mwfCutmWp9hWvUg1ny
/7FROufZmhYMuuyBr5ss/uNjdyjvOBTPSes5h4OXdPu4+HtA5fbKlnsytKpV4DvN
bGO49HcjuUJ0B8auo1FtPR6C9H772Lw8Dk0cyaF/UzeInhXxrCnPhZk1hSoX/Zjv
LRvzjTd0YWa2dhpjVabRmptCeDPMypT6JsTLkOBL8CyFeLbbaeL/uu1SdV7xLP4R
E6yZx+OovcsMtP5+c3WsiUAK1i3MhfcvmpfGQla25c0SJQaRcStyoYzoxlqAErFh
a4UtibZCIzyYlTKl+O18aR6RGFIhOPQCKo8FCdA8JQaCWvPSsqP3795/WJrcikfI
VnEjSVSondjY5hcRlybTtslF5qHV0fGxR86TMo9QxxwKb/nHeqHBlyiIXdHS9OV0
HAmDZYLyPW6gCJwm5BSx9VGVfcv7mmKRIniIjxelCK/wsTRttRHWl2BUFq2Lgv9z
b12kihu954oEBdgkxnLLNRBTVoOowa8a17GRAkYSkAtTghB8VnUBhsjxgUl8UWQv
NI/IEApcjrCFaPGxJyAF0bpmtp5C579Vodp7Ijx+Y9JApvnmh6u0/KTwbXd/+Koc
vj1bXsx/6UsnjbAk2/0Eupxbaw==Для первого запуска оставьте hl, gl и проксичекер как в пресете либо замените их на значения своей инфраструктуры. Сначала выполните несколько тестовых запросов и проверьте ответ, источники и статус задания.
Источники и библиография
- Ahrefs (15 декабря 2025): «Are AI Mode and AI Overviews Just Different Versions of the Same Answer? (730K Responses Studied)» — исследование 730 тыс. пар ответов ИИ в поиске США: 86% смыслового совпадения при пересечении URL-источников в 13,7% случаев (https://ahrefs.com/blog/ai-overviews-vs-ai-mode/).
- Ahrefs (26 ноября 2025): «Do AI Assistants Link When Mentioning Brands? For Ahrefs, Only 28% of the Time» — анализ 31 тыс. упоминаний Ahrefs на шести AI-платформах (https://ahrefs.com/blog/ai-citations-vs-impressions-study/).
- Официальная документация A-Parser: «FreeAI::GoogleAI — Парсер Google AI mode» — описание собираемых полей, форматов результата и настроек парсера (https://a-parser.com/docs/parsers/freeai-googleai).
- Search Engine Journal (6 марта 2026): «Google AI Mode Cites Itself More Often, With More Organic Links» — пересказ исследования SE Ranking по 1,3 млн цитирований AI Mode; Google — 17% цитат, около 20% вместе с YouTube (https://www.searchenginejournal.com/google-ai-mode-cites-itself-more-often-with-more-organic-links/568955/).