Хэллоуин в Pinterest без ручной сортировки: 730 изображений через A-Parser и Clef-Flash
Практическое руководство: на примере выдачи по запросу halloween costumes собираем и классифицируем сотни пинов без сторонних скриптов. В новом реальном тесте связка обработала 730 картинок, из которых 728 успешно классифицированы.
Парсинг Pinterest в A-Parser: сбор ссылок на изображения
Pinterest — визуальная платформа, где ищут идеи оформления интерьера, одежды, рецептов, подарков и других сюжетов. Для e-commerce, контентных проектов и исследования креативов выдача Pinterest может служить источником визуальных референсов и примеров.
В преддверии Хэллоуина особенно востребована выдача с костюмами, гримом, декором и идеями для вечеринок. В актуальном реальном тесте один из восьми ключей — halloween costumes, поэтому сезонные пины сразу попадают в общую базу для дальнейшей классификации.
С технической точки зрения собрать ссылки на такие пины — простая задача. Встроенный в A-Parser парсер  SE::Pinterest работает «из коробки» и в многопоточном режиме обеспечивает высокую скорость сбора:
- Сбор оригиналов: выгрузка прямых ссылок на полноразмерные изображения с CDN (
https://i.pinimg.com/originals/...); - Автоматизация: встроенная строковая уникализация исключает повторный сбор одних и тех же картинок.
Узкое горлышко: как быстро разобрать собранные ссылки по категориям
Спарсить выдачу Pinterest — дело нескольких минут. Однако состав сырой выборки сильно зависит от поискового запроса: на узких тематических ключах контент относительно однороден, но на широких коммерческих нишах неизбежно накапливается смесь из предметных фото, любительских снимков, инфографики и юмора.
Для быстрой фильтрации и раскладки таких объёмов по категориям можно использовать модели принятия решений (decision models). В нашей цепочке заданий используется мультимодальная модель cloudflare/clef-flash: она не генерирует свободный текст, а возвращает категорию и скоринг за один прямой проход.
Классификация изображений Pinterest: почему Clef-Flash, а не обычная LLM
Почему текстовые модели не подходят для классификации изображений
В экосистеме OpenRouter наряду с классическими диалоговыми моделями действует специализированный протокол Decisions API, первыми представителями которого стали Jev от TypeSafe и Clef / Clef-Flash от Cloudflare.
Идея возникла из практической проблемы: диалоговые LLM создавались для генерации связной речи, а не для потоковой пакетной фильтрации данных. Когда языковую модель просят классифицировать изображение или текст, она тратит время на пошаговый вывод каждого токена, тарифицирует объем сгенерированного ответа и нередко нарушает структуру JSON (в особенности китайские модели; в GPT есть Structured Output, но это тема другой статьи).
Модели решений работают иначе: они принимают входные данные (состояние) и список типизированных вопросов, оценивая их за один прямой проход нейросети без генерации текста. Ответ возвращается через строгие программные примитивы:
- Choice — выбор одной из категорий с расчетом вероятностей по всем вариантам;
- Noul — вероятность истинности утверждения (число от 0.0 до 1.0);
- Score — позиция объекта на заданной шкале.
Ключевое отличие в экономике: выходные токены здесь не генерируются и не тарифицируются. В актуальном тесте с десятью категориями себестоимость одного запроса к cloudflare/clef-flash составила $0.0000528 (около половины одной сотой цента).
Визуальный скоринг с Cloudflare Clef-Flash
Если первые решения работали преимущественно с текстом, то мультимодальная линейка Clef от Cloudflare добавила нативную поддержку изображений: модель принимает визуальные данные непосредственно в состоянии запроса и возвращает вероятности по классам.
Модель cloudflare/clef-flash в OpenRouter поддерживается несколькими независимыми провайдерами (включая Cloudflare и DeepInfra), однако для надежной работы с изображениями в нашем пресете зафиксирован апстрим Cloudflare.
| Параметр | Обычные генеративные LLM | Модель решений (cloudflare/clef-flash) |
|---|---|---|
| Принцип работы | Пошаговая генерация текста | Классификация и скоринг без генерации текста |
| Механизм вывода | Авторегрессионный расчет каждого токена | Оценка в один прямой проход нейросети |
| Типичная задержка | 2 000 – 4 500 мс (по нашей оценке) | 80 – 250 мс (по нашей оценке инференса) |
| Выходные токены | Тарифицируются по отдельной ставке | Бесплатны (выходной текст отсутствует) |
| Соблюдение схемы | Возможны ошибки форматирования JSON | 100% строгая типизация ответов |
| Стоимость запроса | ~$0.002 – $0.005 (оценка) | ~$0.00005 (измерено в реальном тесте) |
Clef-Flash не рассуждает и не пишет текст. Модель принимает картинку с набором критериев и за доли секунды возвращает готовые вероятности, делая потоковую фильтрацию тысяч изображений быстрой и предсказуемой по затратам.
Материалы Halloween-теста на 730 пинов:
* Скачать файл результатов классификации (CSV) — полный датасет с URL пинов, категориями, вероятностями, educational-скором и стоимостью.
* Открыть интерактивную таблицу с превью картинок (HTML) — веб-отчет с фильтрацией, бейджами классов и миниатюрами каждого пина.
Связка Pinterest, A-Parser и Clef-Flash: три задания
Связка работает исключительно на штатном функционале A-Parser — без внешних скриптов и дополнительной инфраструктуры.
Логика цепочки: SE::Pinterest → Net::HTTP (скачивание) → Net::HTTP (Clef-Flash) → CSV.
- Встроенный парсер SE::Pinterest собирает прямые ссылки на изображения.
- Первое задание
Net::HTTPскачивает картинки и подготавливает их для модели. - Второе задание
Net::HTTPотправляет изображения в Clef-Flash, получает категорию и записывает результат в CSV.
Все технические параметры и готовые шаблоны разобраны в следующем разделе.
Результаты теста: 730 изображений, 10 категорий и $0,04
Цепочка была проверена на рабочем инстансе A-Parser в 20 потоков по восьми ключевым запросам, включая halloween costumes: из 730 картинок успешно классифицировано 728 (99,7%).
Как читать категории и оценку
Для демонстрации возможностей Clef-Flash в одном запросе мы задаём модели два независимых вопроса. Она одновременно возвращает тематическую категорию изображения и отдельную числовую оценку обучающего содержания.
theme— основной ответ: к какой из десяти тематик относится картинка;educational— второй, демонстрационный для этой статьи ответ со значением от 0 до 1: насколько изображение похоже на инфографику, схему, инструкцию или чек-лист.
Таким образом, один вызов API показывает два типа результатов: выбор категории (choice) и числовую оценку признака (noul). Например, DIY-картинка может относиться к diy_crafts и одновременно иметь высокий балл educational.
Ключевое различие для Pinterest — назначение текста на изображении:
- текст ради шутки, сарказма или реакции относится к
meme; - текст, который объясняет, учит или показывает последовательность действий, — к
educational_diagram.
Распределение по 10 классам
Распределение рассчитано по 728 успешным ответам. Названия категорий в таблице соответствуют значениям поля theme в CSV: meme — мемы; fashion_beauty — мода и красота; sports_football — спорт и футбол; diy_crafts — DIY и рукоделие; educational_diagram — инфографика и обучающие схемы; food_drink — еда и напитки; interior_design_home — интерьер и дом; travel_places — путешествия и достопримечательности; halloween — костюмы, грим, тыквы и праздничный декор; other — прочее.
| Категория | Изображений | Доля |
|---|---|---|
fashion_beauty | 131 | 18,0% |
sports_football | 117 | 16,1% |
interior_design_home | 116 | 15,9% |
meme | 114 | 15,7% |
diy_crafts | 110 | 15,1% |
halloween | 98 | 13,5% |
food_drink | 40 | 5,5% |
educational_diagram | 2 | 0,3% |
other | 0 | 0,0% |
travel_places | 0 | 0,0% |
Уверенность классификации и оценка обучающего контента
- Средняя уверенность в тематике: 0,8817 (88,2%).
- Медиана уверенности: 0,9045 (90,5%).
- Доля ответов с уверенностью выше 80%: 87,4%.
Уверенность модели по категориям
- Интерьер: 0,961 (96,1%);
- Мемы: 0,941 (94,1%);
- Еда и напитки: 0,914 (91,4%);
- Спорт: 0,896 (89,6%);
- Мода и красота: 0,863 (86,3%);
- DIY и рукоделие: 0,818 (81,8%);
- Хэллоуин: 0,792 (79,2%) — пограничные образы пересекаются с модой, гримом и рукоделием, поэтому для этого класса разумно применять более мягкий порог уверенности.
Костюмы на Хэллоуин: примеры классификации
| Образ 1 | Образ 2 | Образ 3 | Образ 4 |
|---|---|---|---|
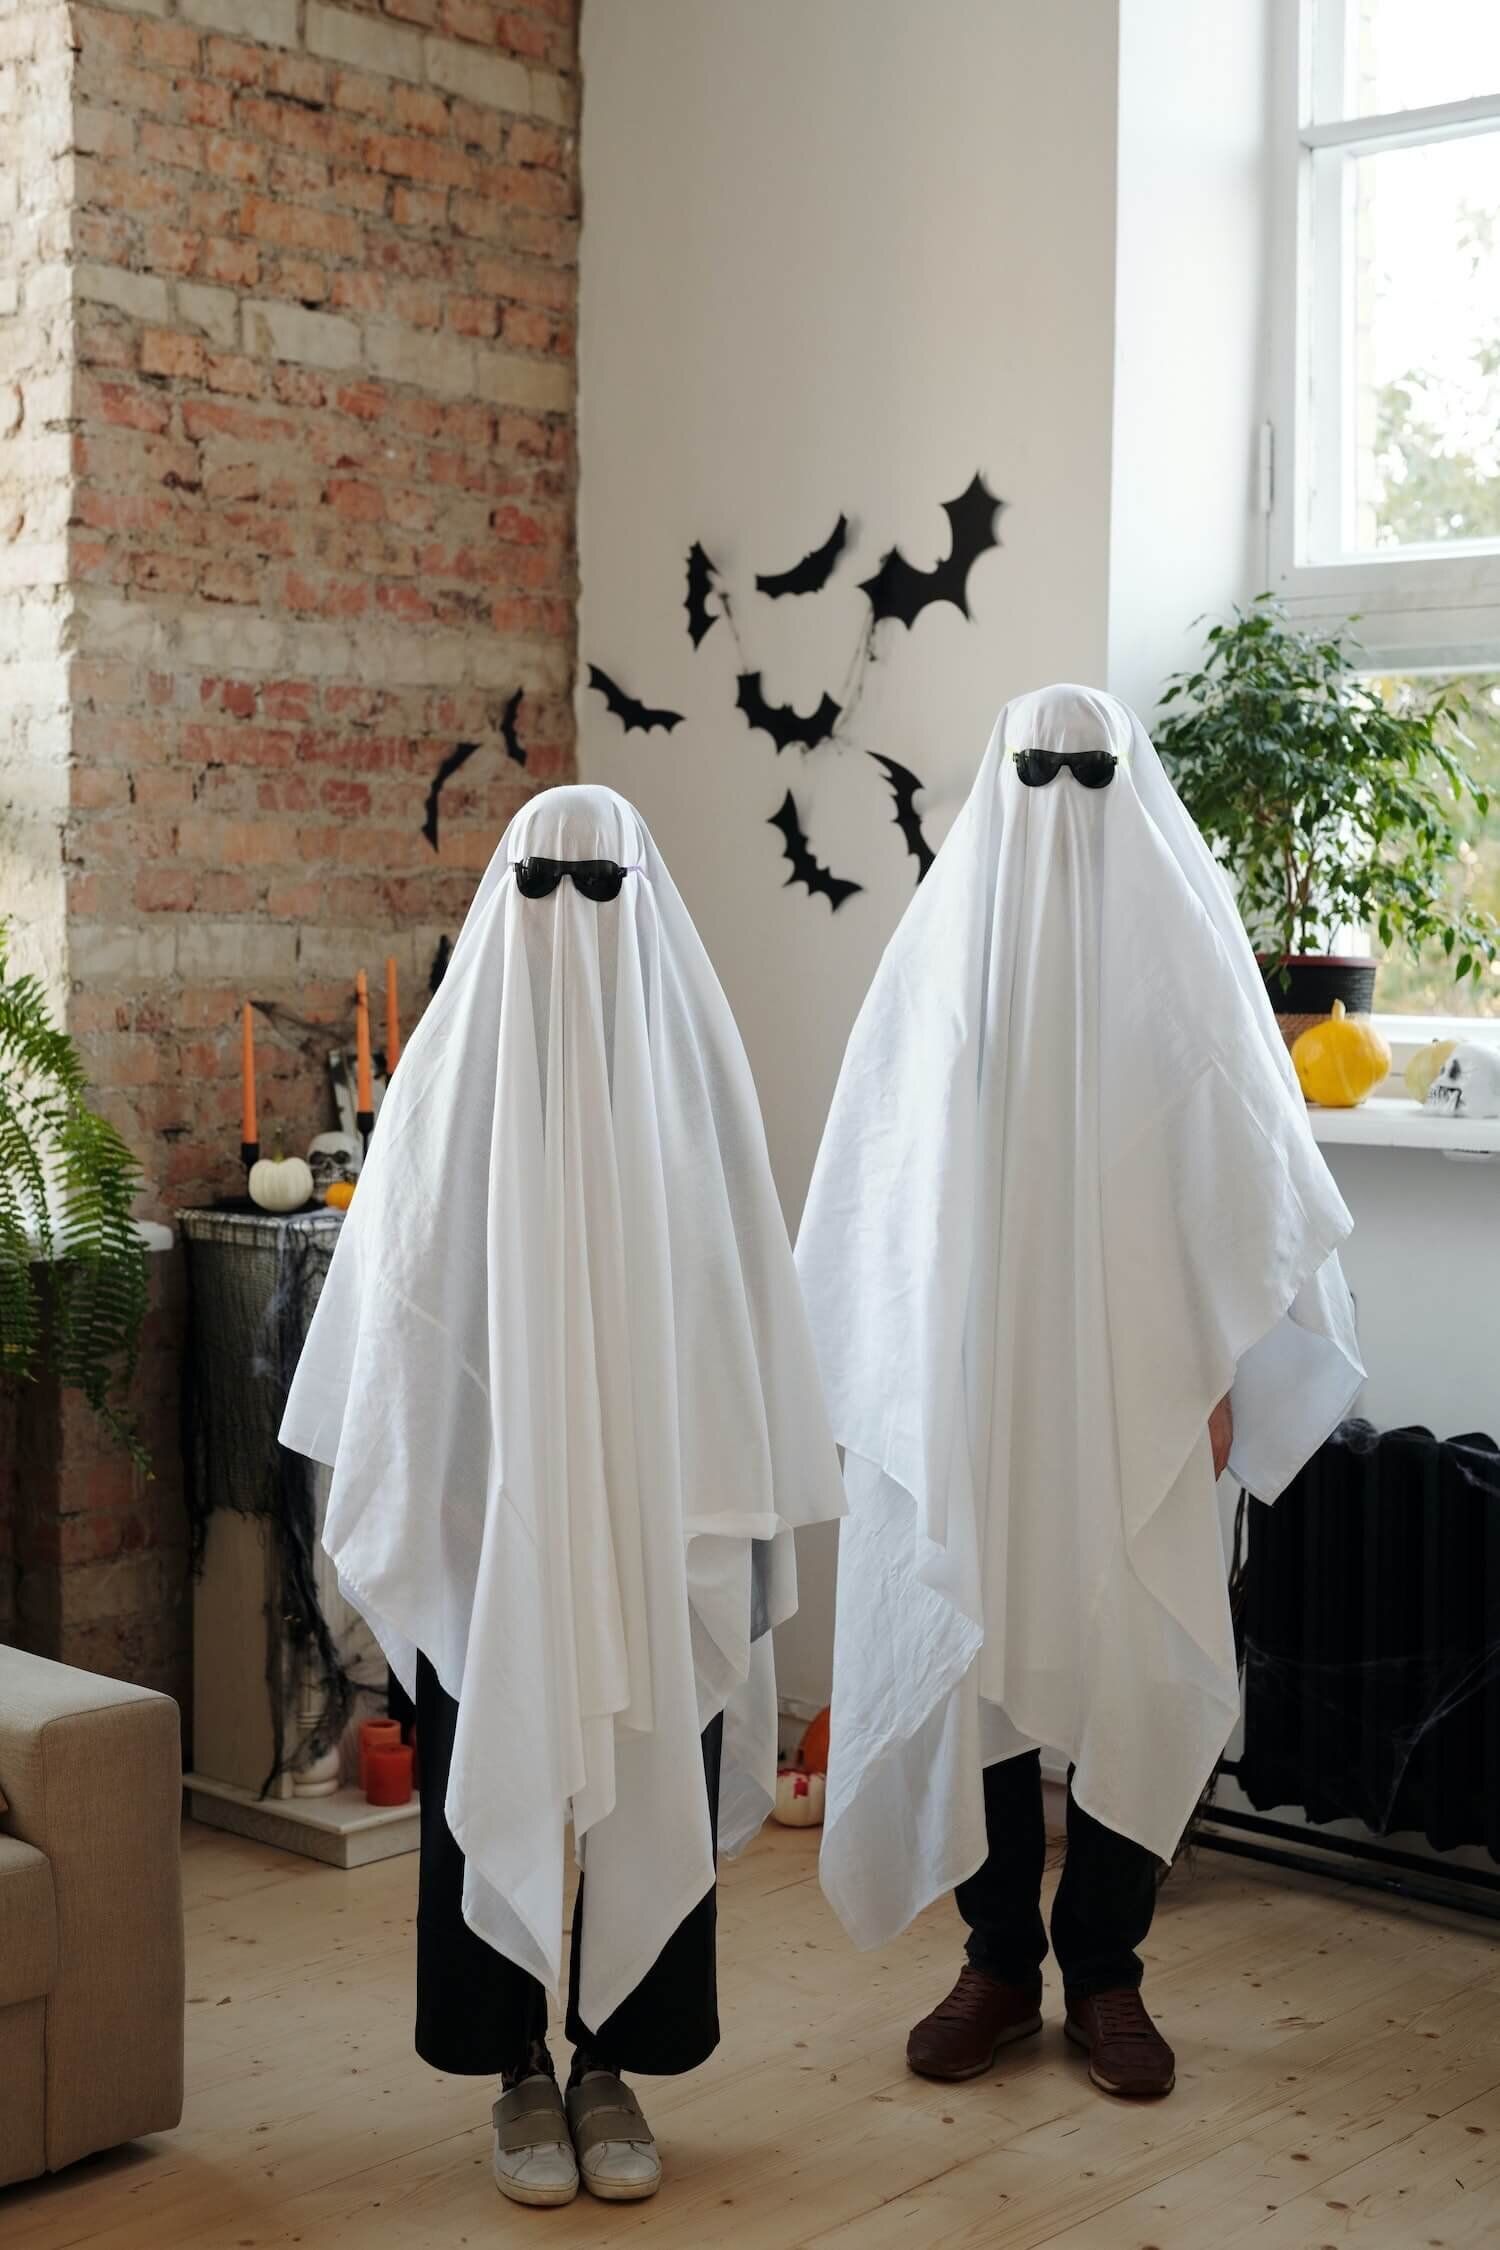 Хэллоуин: 0,921 (92,1%) Обучающий контент: 0,023 | 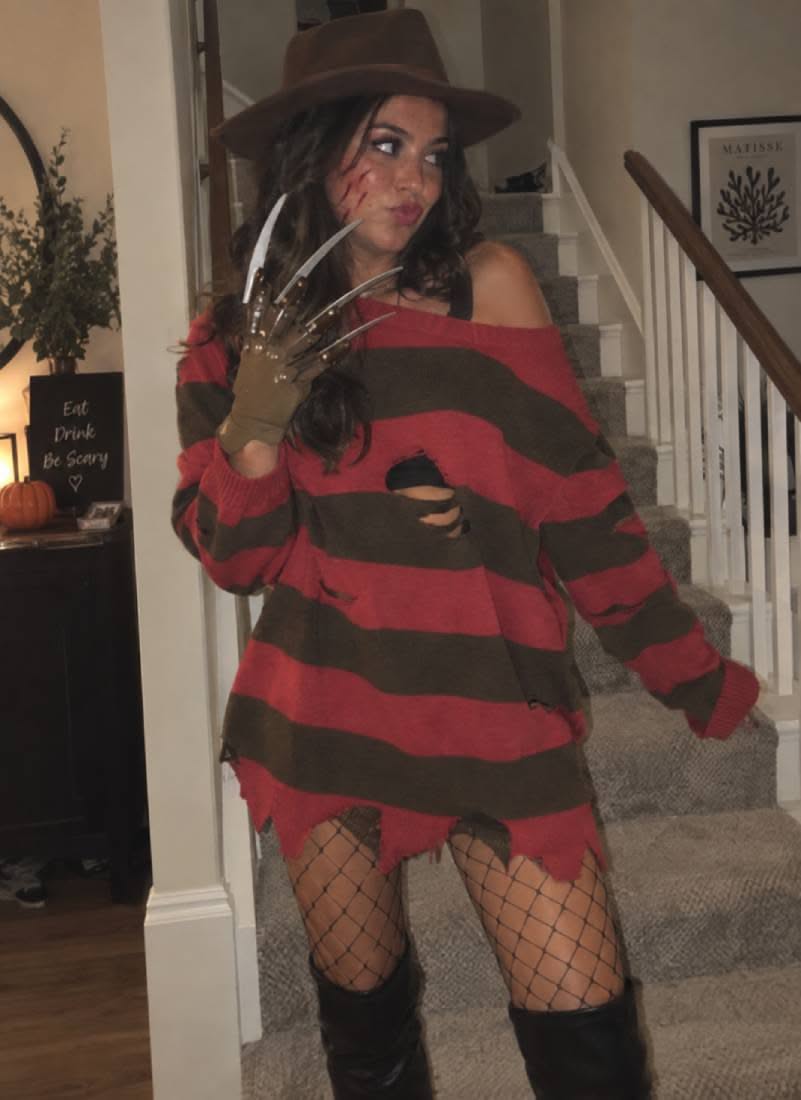 Хэллоуин: 0,929 (92,9%) Обучающий контент: 0,021 | 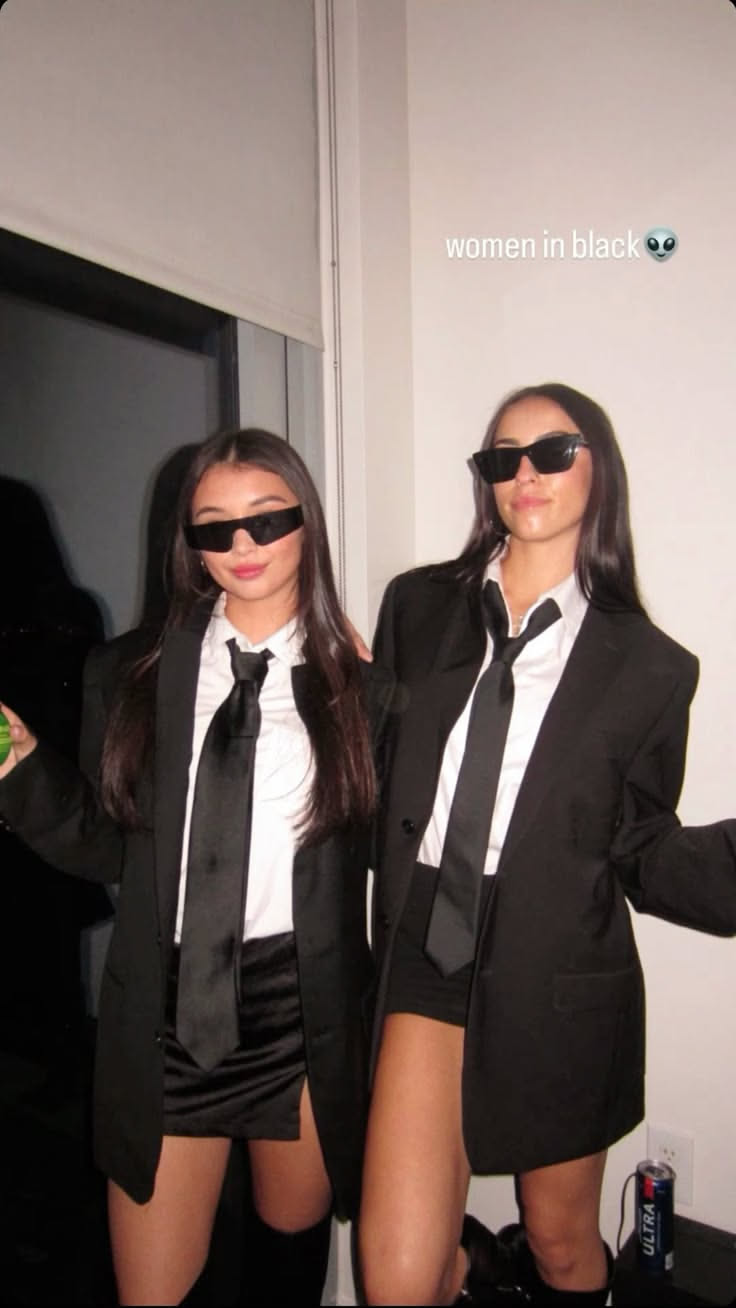 Хэллоуин: 0,704 (70,4%) Обучающий контент: 0,008 | 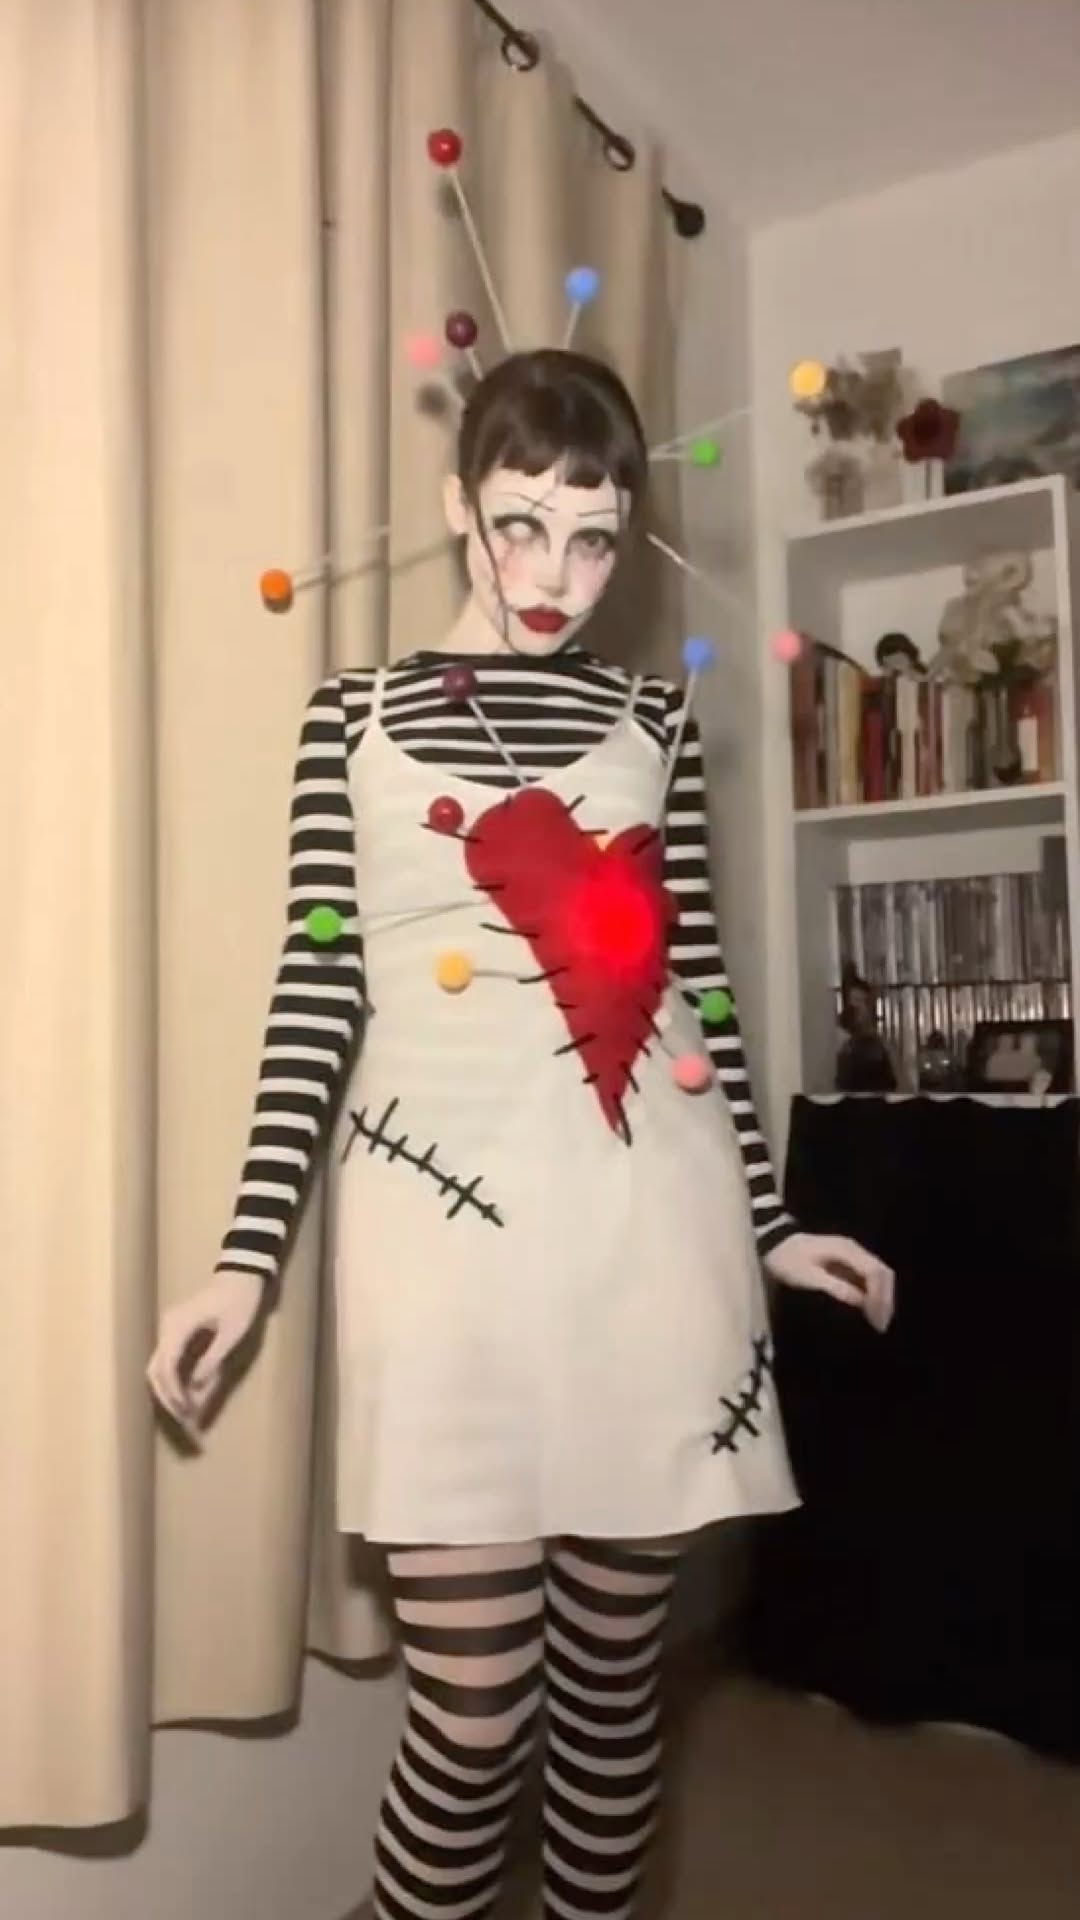 Хэллоуин: 0,862 (86,2%) Обучающий контент: 0,025 |
Разные типы пинов и высокий обучающий балл
| Мем | Спорт | Интерьер | DIY-инструкция | Инфографика |
|---|---|---|---|---|
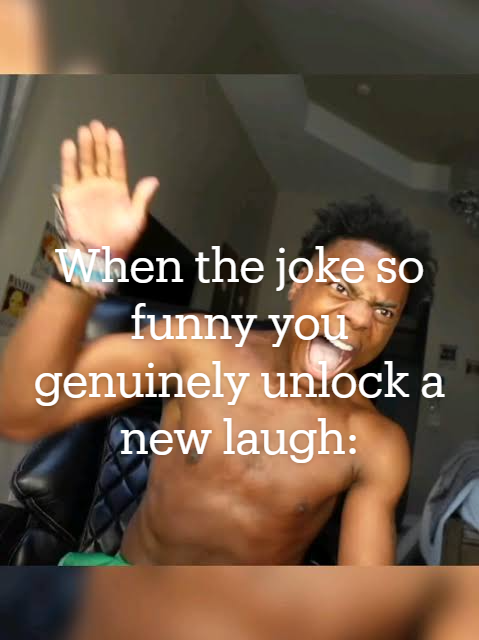 Мем: 0,973 (97,3%) Обучающий контент: 0,009 | 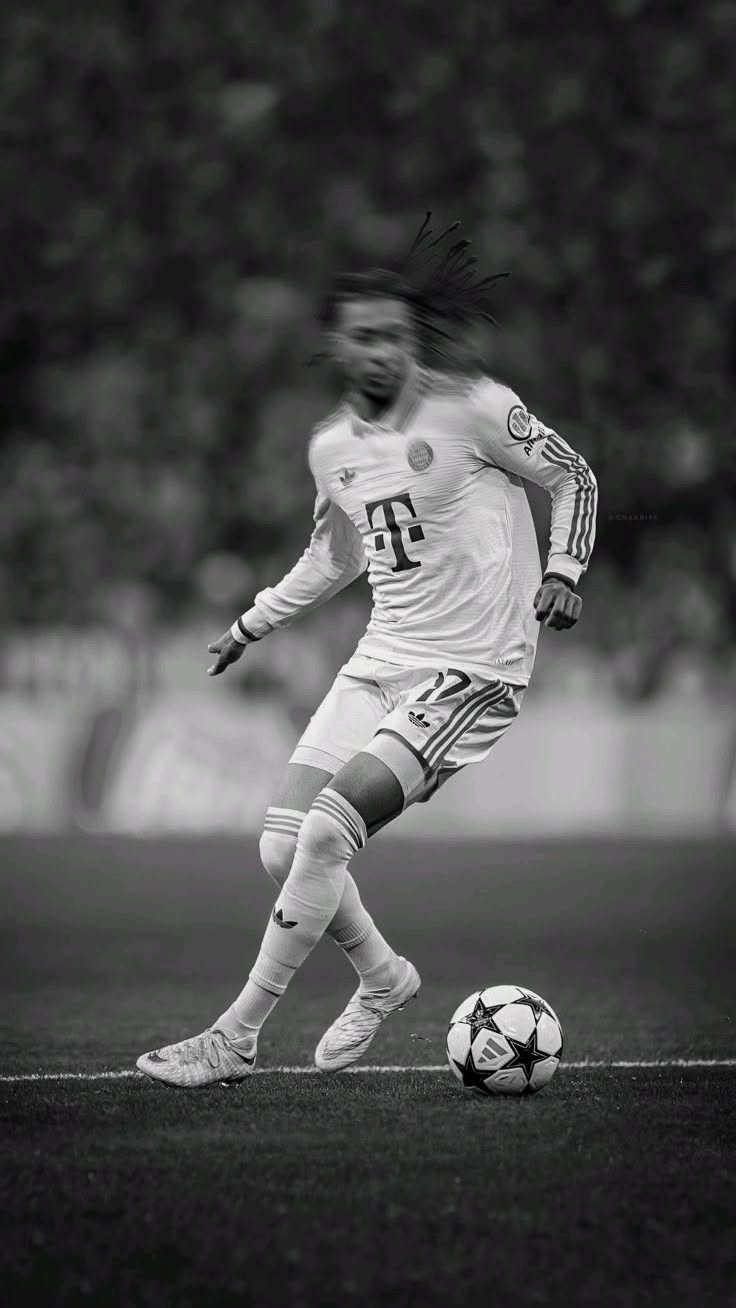 Спорт: 0,968 (96,8%) Обучающий контент: 0,016 | 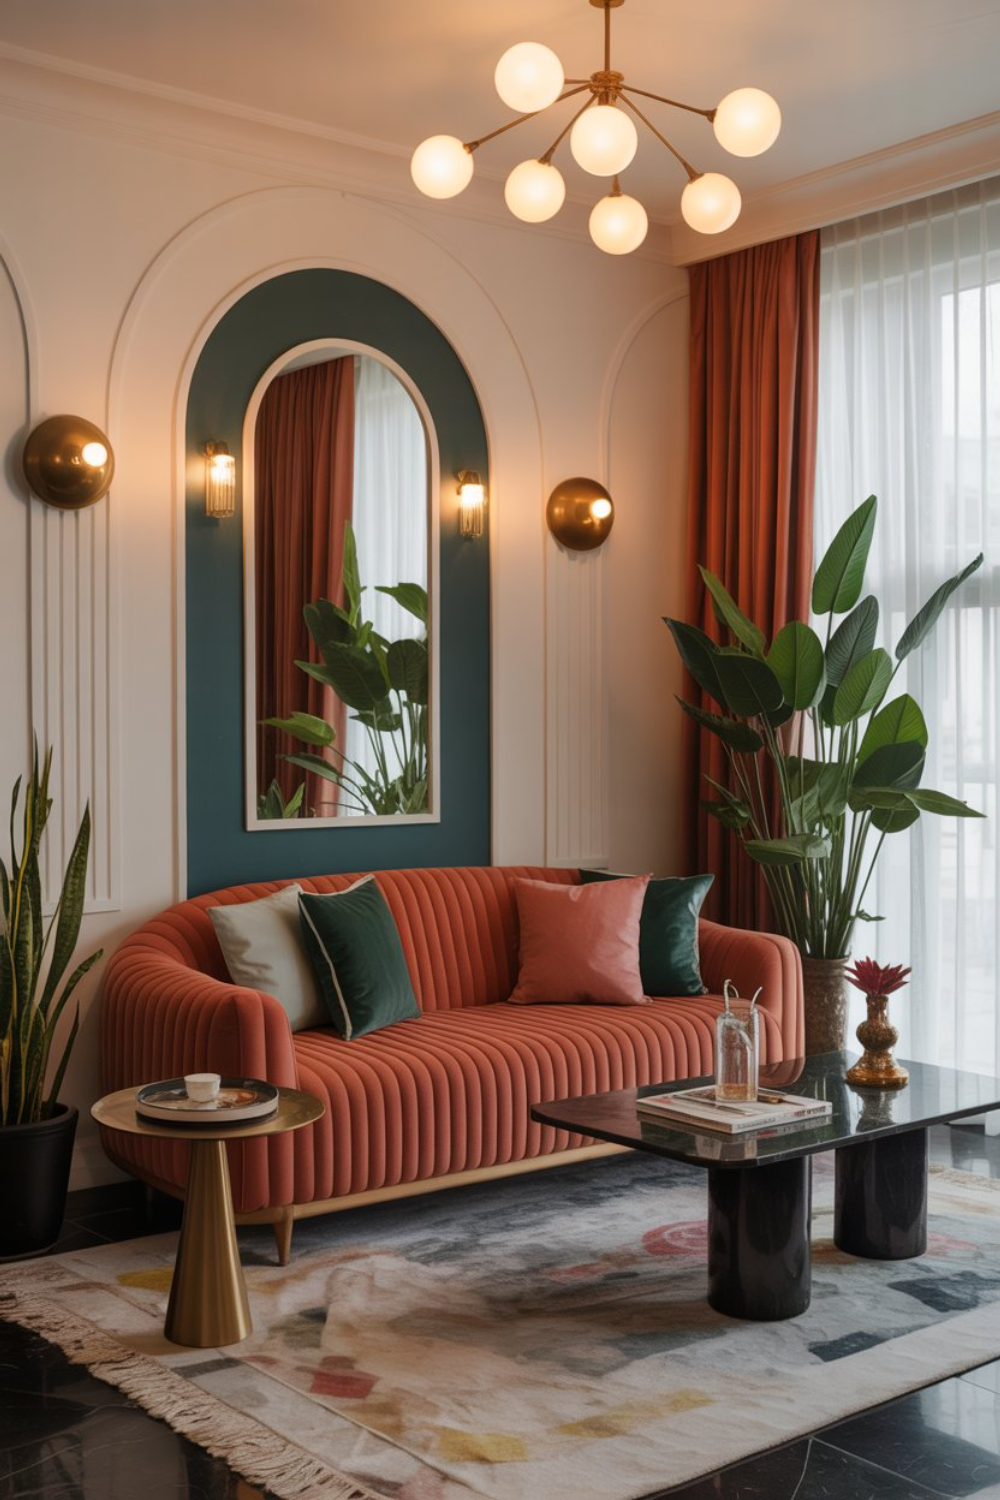 Интерьер: 0,979 (97,9%) Обучающий контент: 0,017 | 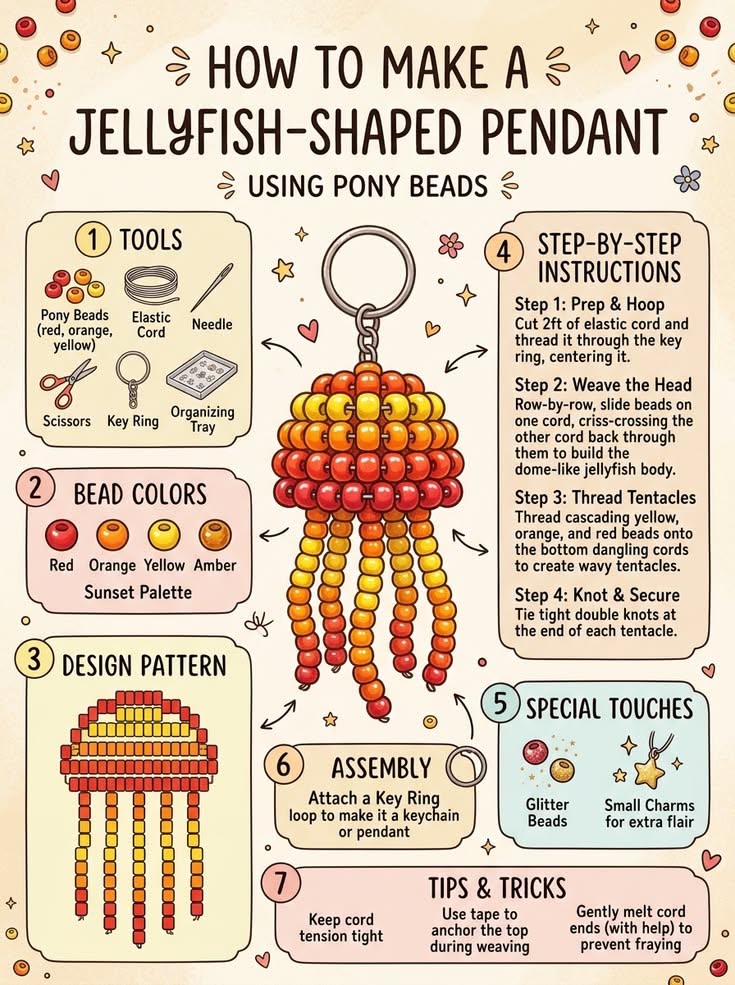 DIY: 0,604 (60,4%) Обучающий контент: 0,965 (96,5%) | 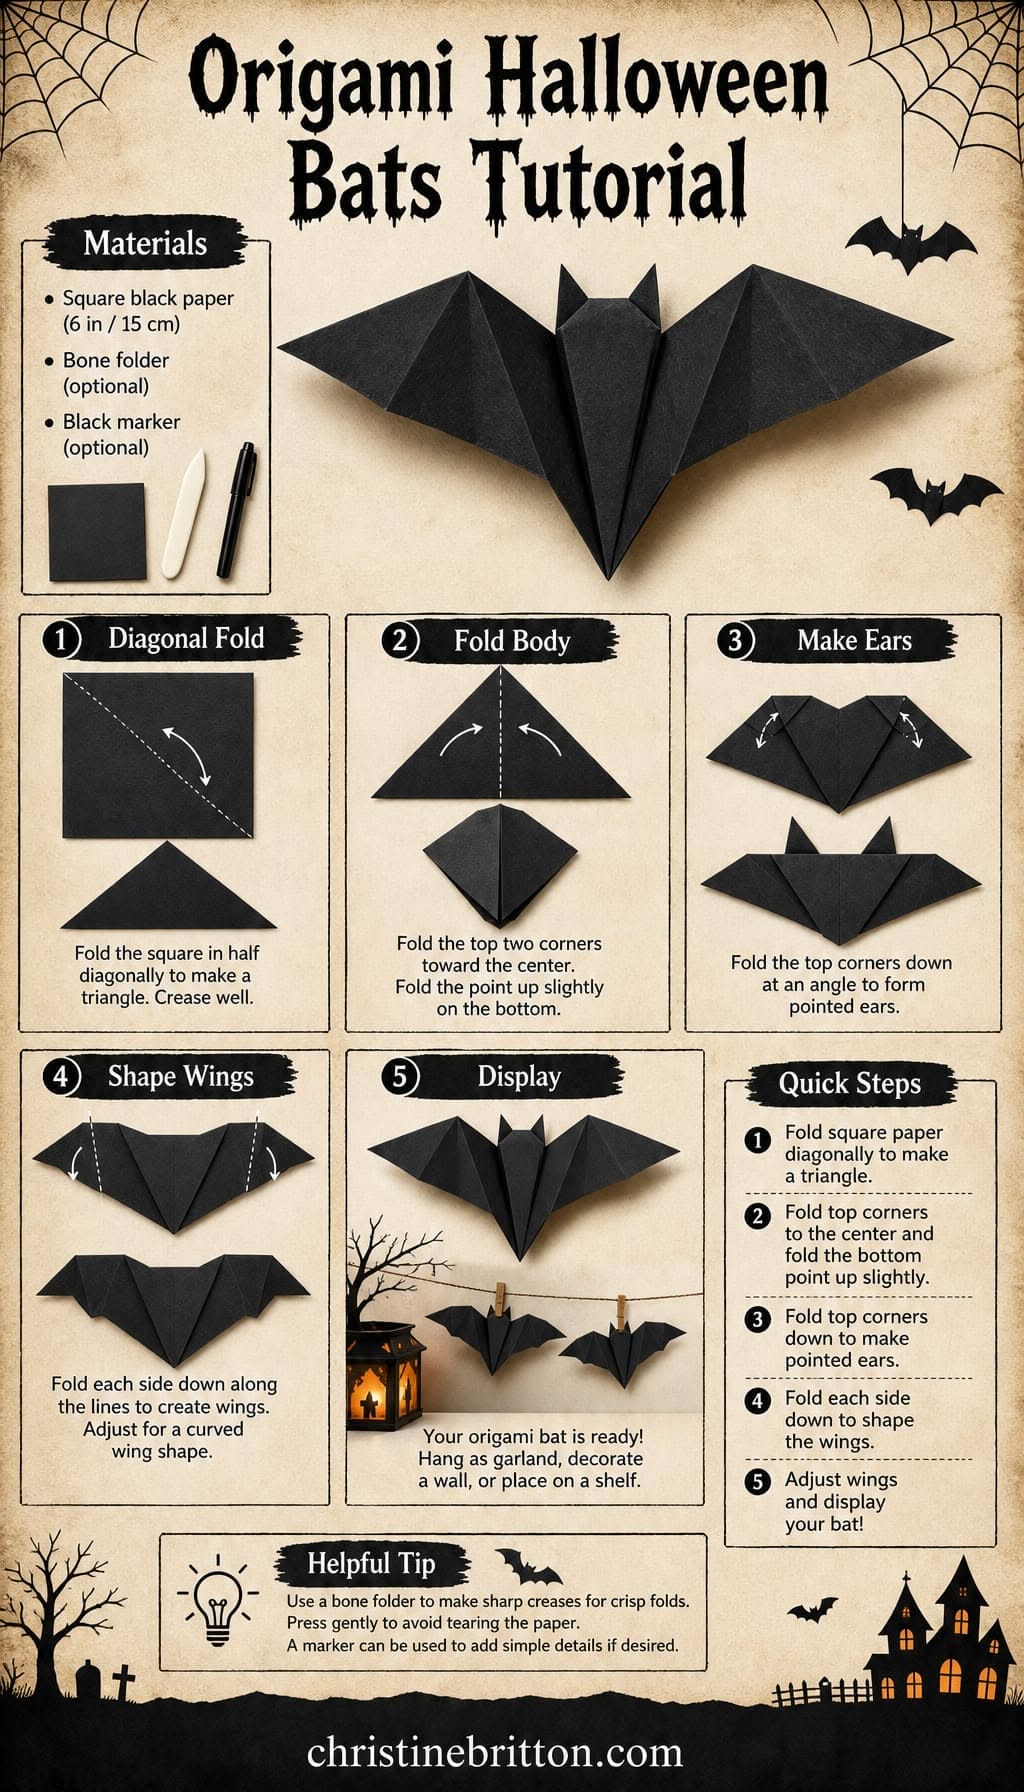 Инфографика: 0,466 (46,6%) Обучающий контент: 0,962 (96,2%) |
Оценка обучающего контента по категориям
- Инфографика и обучающие схемы: средний балл 0,646 (64,6%); в выборке только 2 изображения, поэтому вывод нерепрезентативен.
- DIY и рукоделие: средний балл 0,421 (42,1%).
- Еда и напитки: средний балл 0,189 (18,9%).
- Хэллоуин: средний балл 0,074 (7,4%).
- Мода и красота: средний балл 0,034 (3,4%).
- Мемы и спорт: средний балл 0,015 (1,5%).
Почему 2 изображения не классифицировались: лимиты Clef
В основном реальном тесте две картинки не были классифицированы. Дополнительная ручная проверка через API показала, что у Clef есть два независимых ограничения:
- Ограничение по разрешению: файл объёмом 3,7 МБ в Base64 с разрешением 3355×5032 вернул
image dimensions are too large. Ошибка связана с числом пикселей, а не с весом файла. - Ограничение по декодированному объёму: PNG размером 5,4 и 5,1 МБ при умеренном разрешении вернули
image exceeds the decoded byte limit. - Контрольный пример: изображение объёмом 4,2 МБ в Base64 и разрешением 1080×1920 прошло классификацию успешно.
Это не опубликованные жёсткие пороги модели, а практические границы наблюдений: по объёму Base64 — между 4,2 и примерно 6,7 МБ, по разрешению — между 4 и 17 мегапикселями. Проверять нужно оба параметра: JPG на 2–3 МБ, но с разрешением 17–35 мегапикселей, также возвращали image dimensions are too large.
Фактические затраты на тест
- Суммарные затраты на 728 классификаций: $0.038412 (около 3,8 цента).
- Средняя себестоимость одной классификации: $0.0000528.
- Масштабируемость затрат: при такой себестоимости обработка массива в 100 000 картинок обойдется примерно в ~$5.28.
- Провайдер: во всех 728 успешных ответах — Cloudflare.
Настройка A-Parser: три задания для Pinterest и Clef-Flash
Задание 1. SE::Pinterest — сбор ссылок на оригиналы через прокси
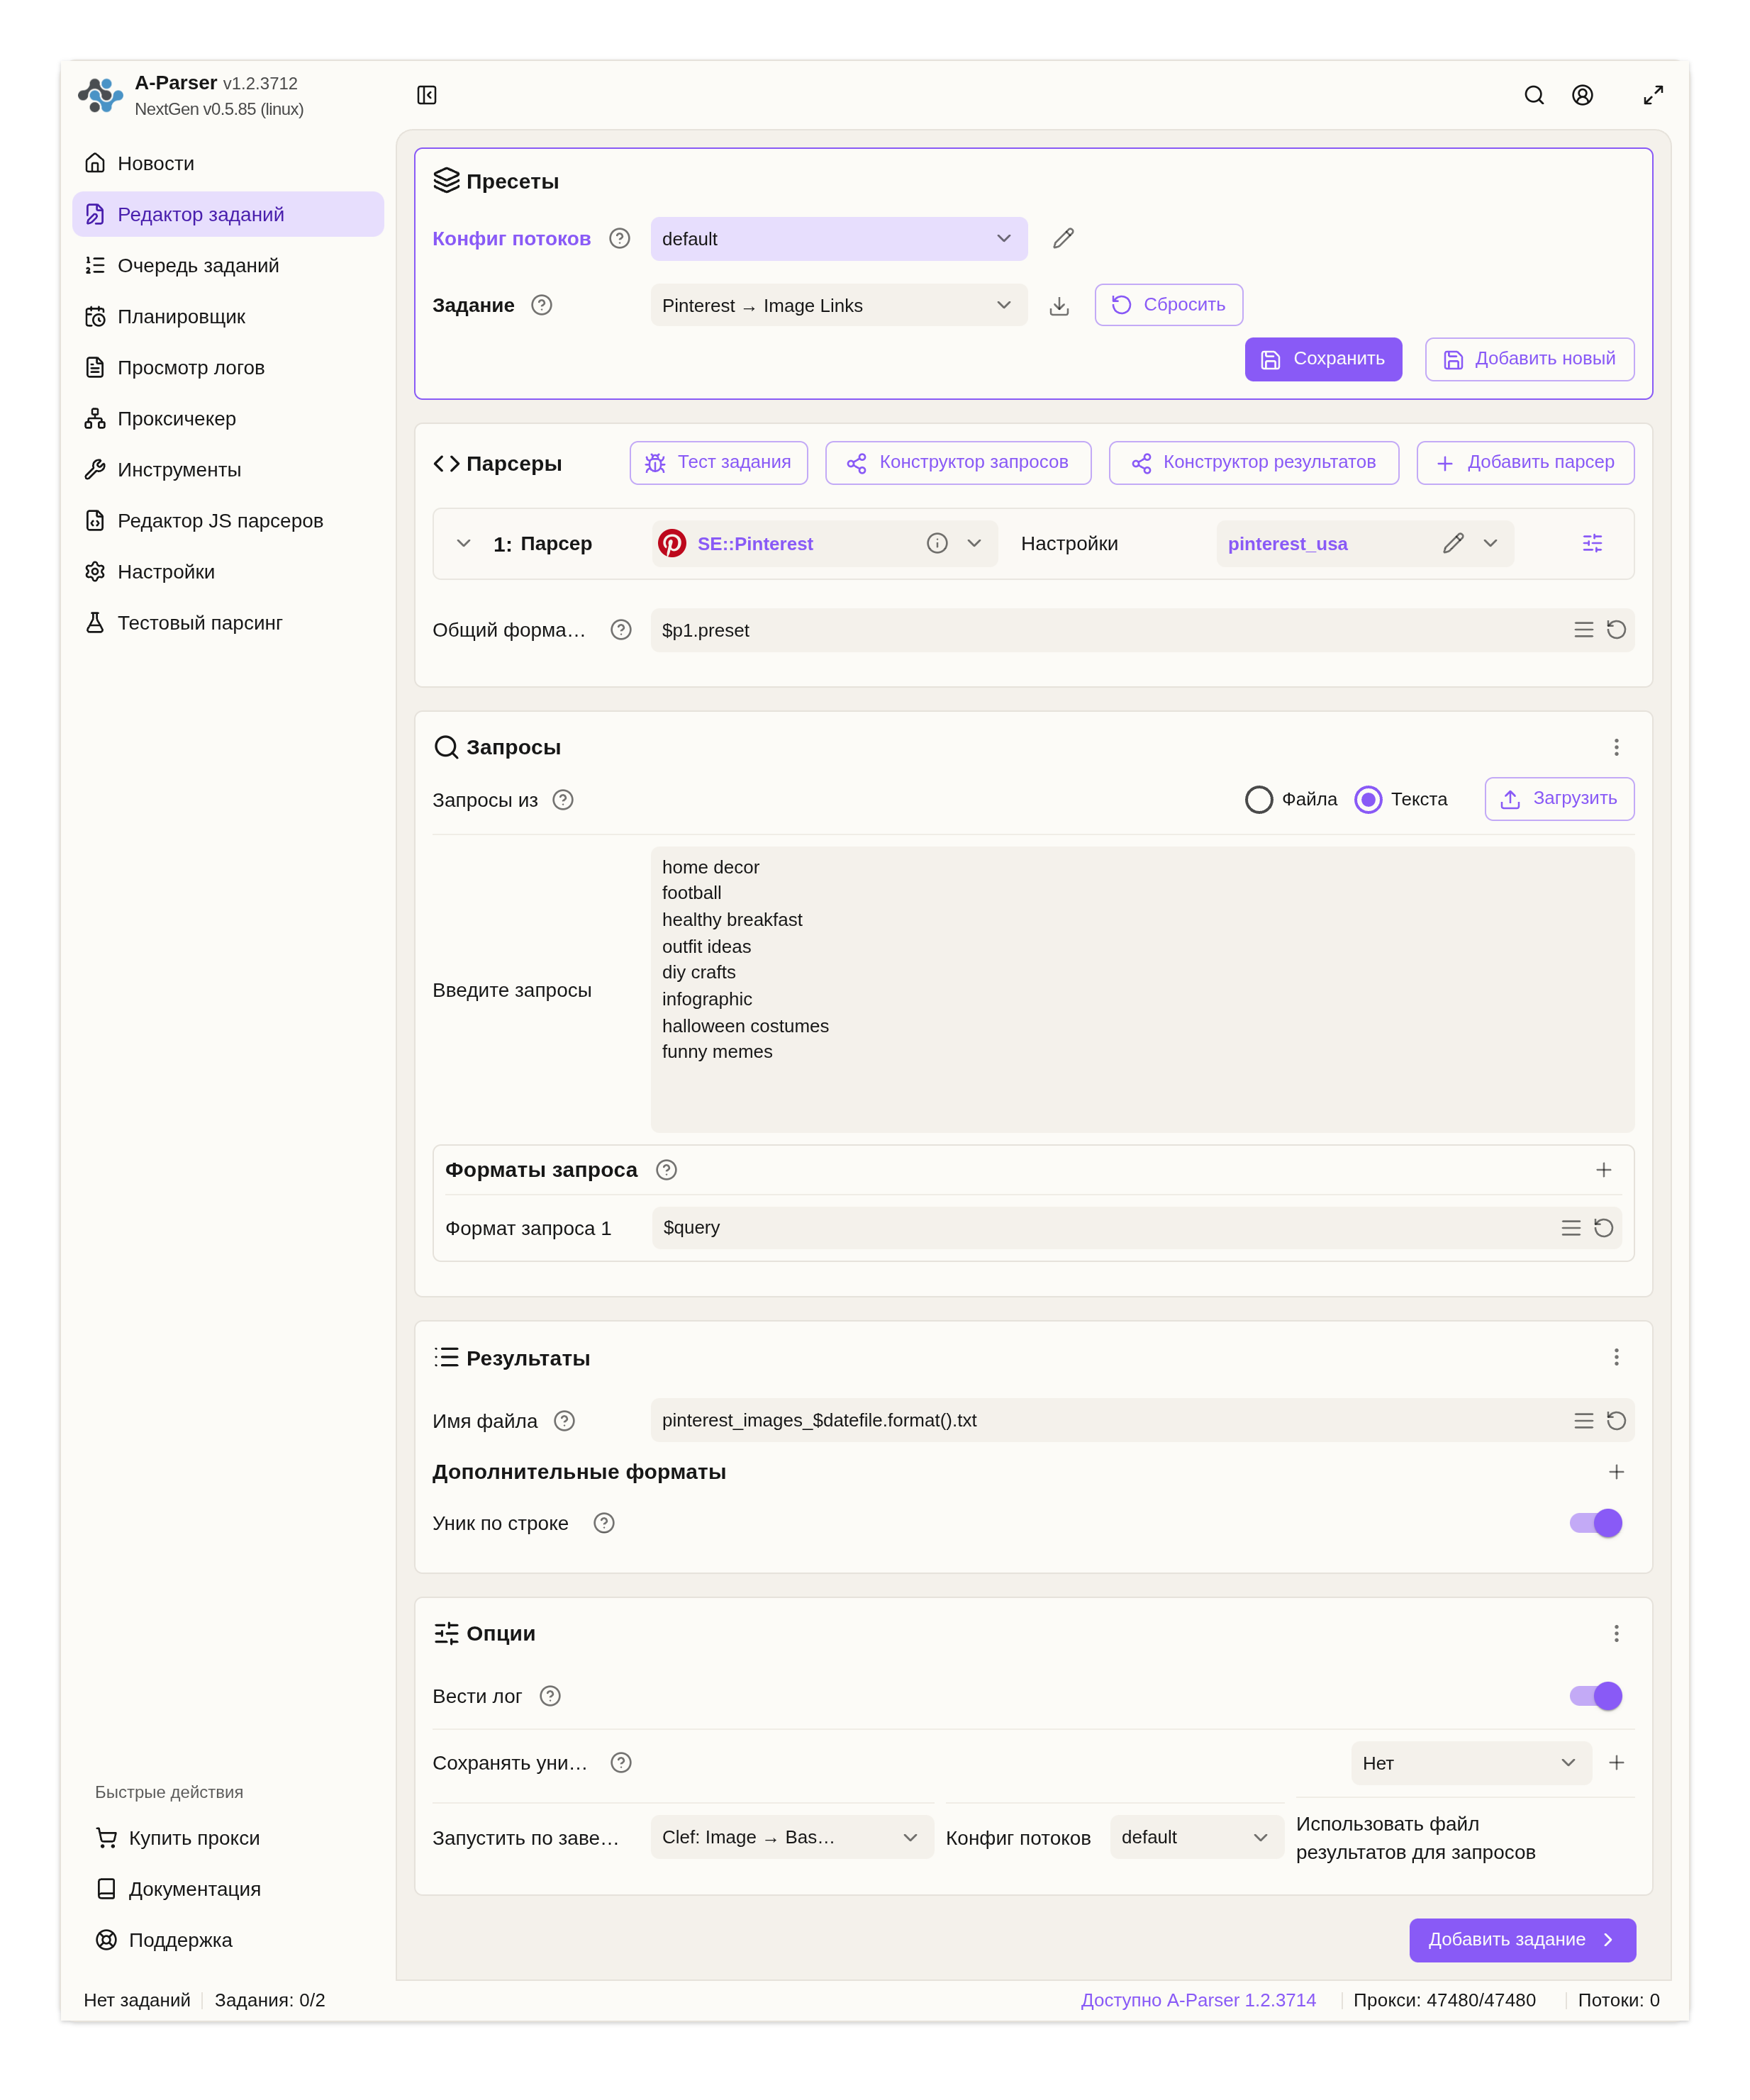
Задание 1 в редакторе A-Parser: встроенный парсер SE::Pinterest, список запросов, файл результатов и запуск следующего звена.
Парсер:
SE::Pinterest.Прокси:
useproxy = 1,proxyretries = 10(работа через настроенный пул прокси).Запросы: Список ниш или ключевых слов (по одному в строке). В новом реальном тесте использовались 8 ключей:
home decor,football,healthy breakfast,outfit ideas,diy crafts,infographic,halloween costumes,funny memes.Формат результата:
$p1.preset(отдает собранные парсером прямые ссылки на полноразмерные изображения).Имя файла результатов:
pinterest_images_$datefile.format().txt.Уникализация: Включена строковая уникализация (
string), исключающая повторный сбор одних и тех же картинок.Связка с Заданием 2: В блоке дополнительных настроек задаем:
runTaskOnComplete:Clef: Image → Base64;useResultsFileAsQueriesFile:true(опция «Использовать файл результатов для запросов»).
Важно по прокси: Прокси нужны только первому звену. Pinterest охотно отдает сотни пинов, но при больших объёмах чувствителен к IP-адресам, поэтому
Задание 2. Net::HTTP — скачивание картинок, фильтрация GIF и Base64
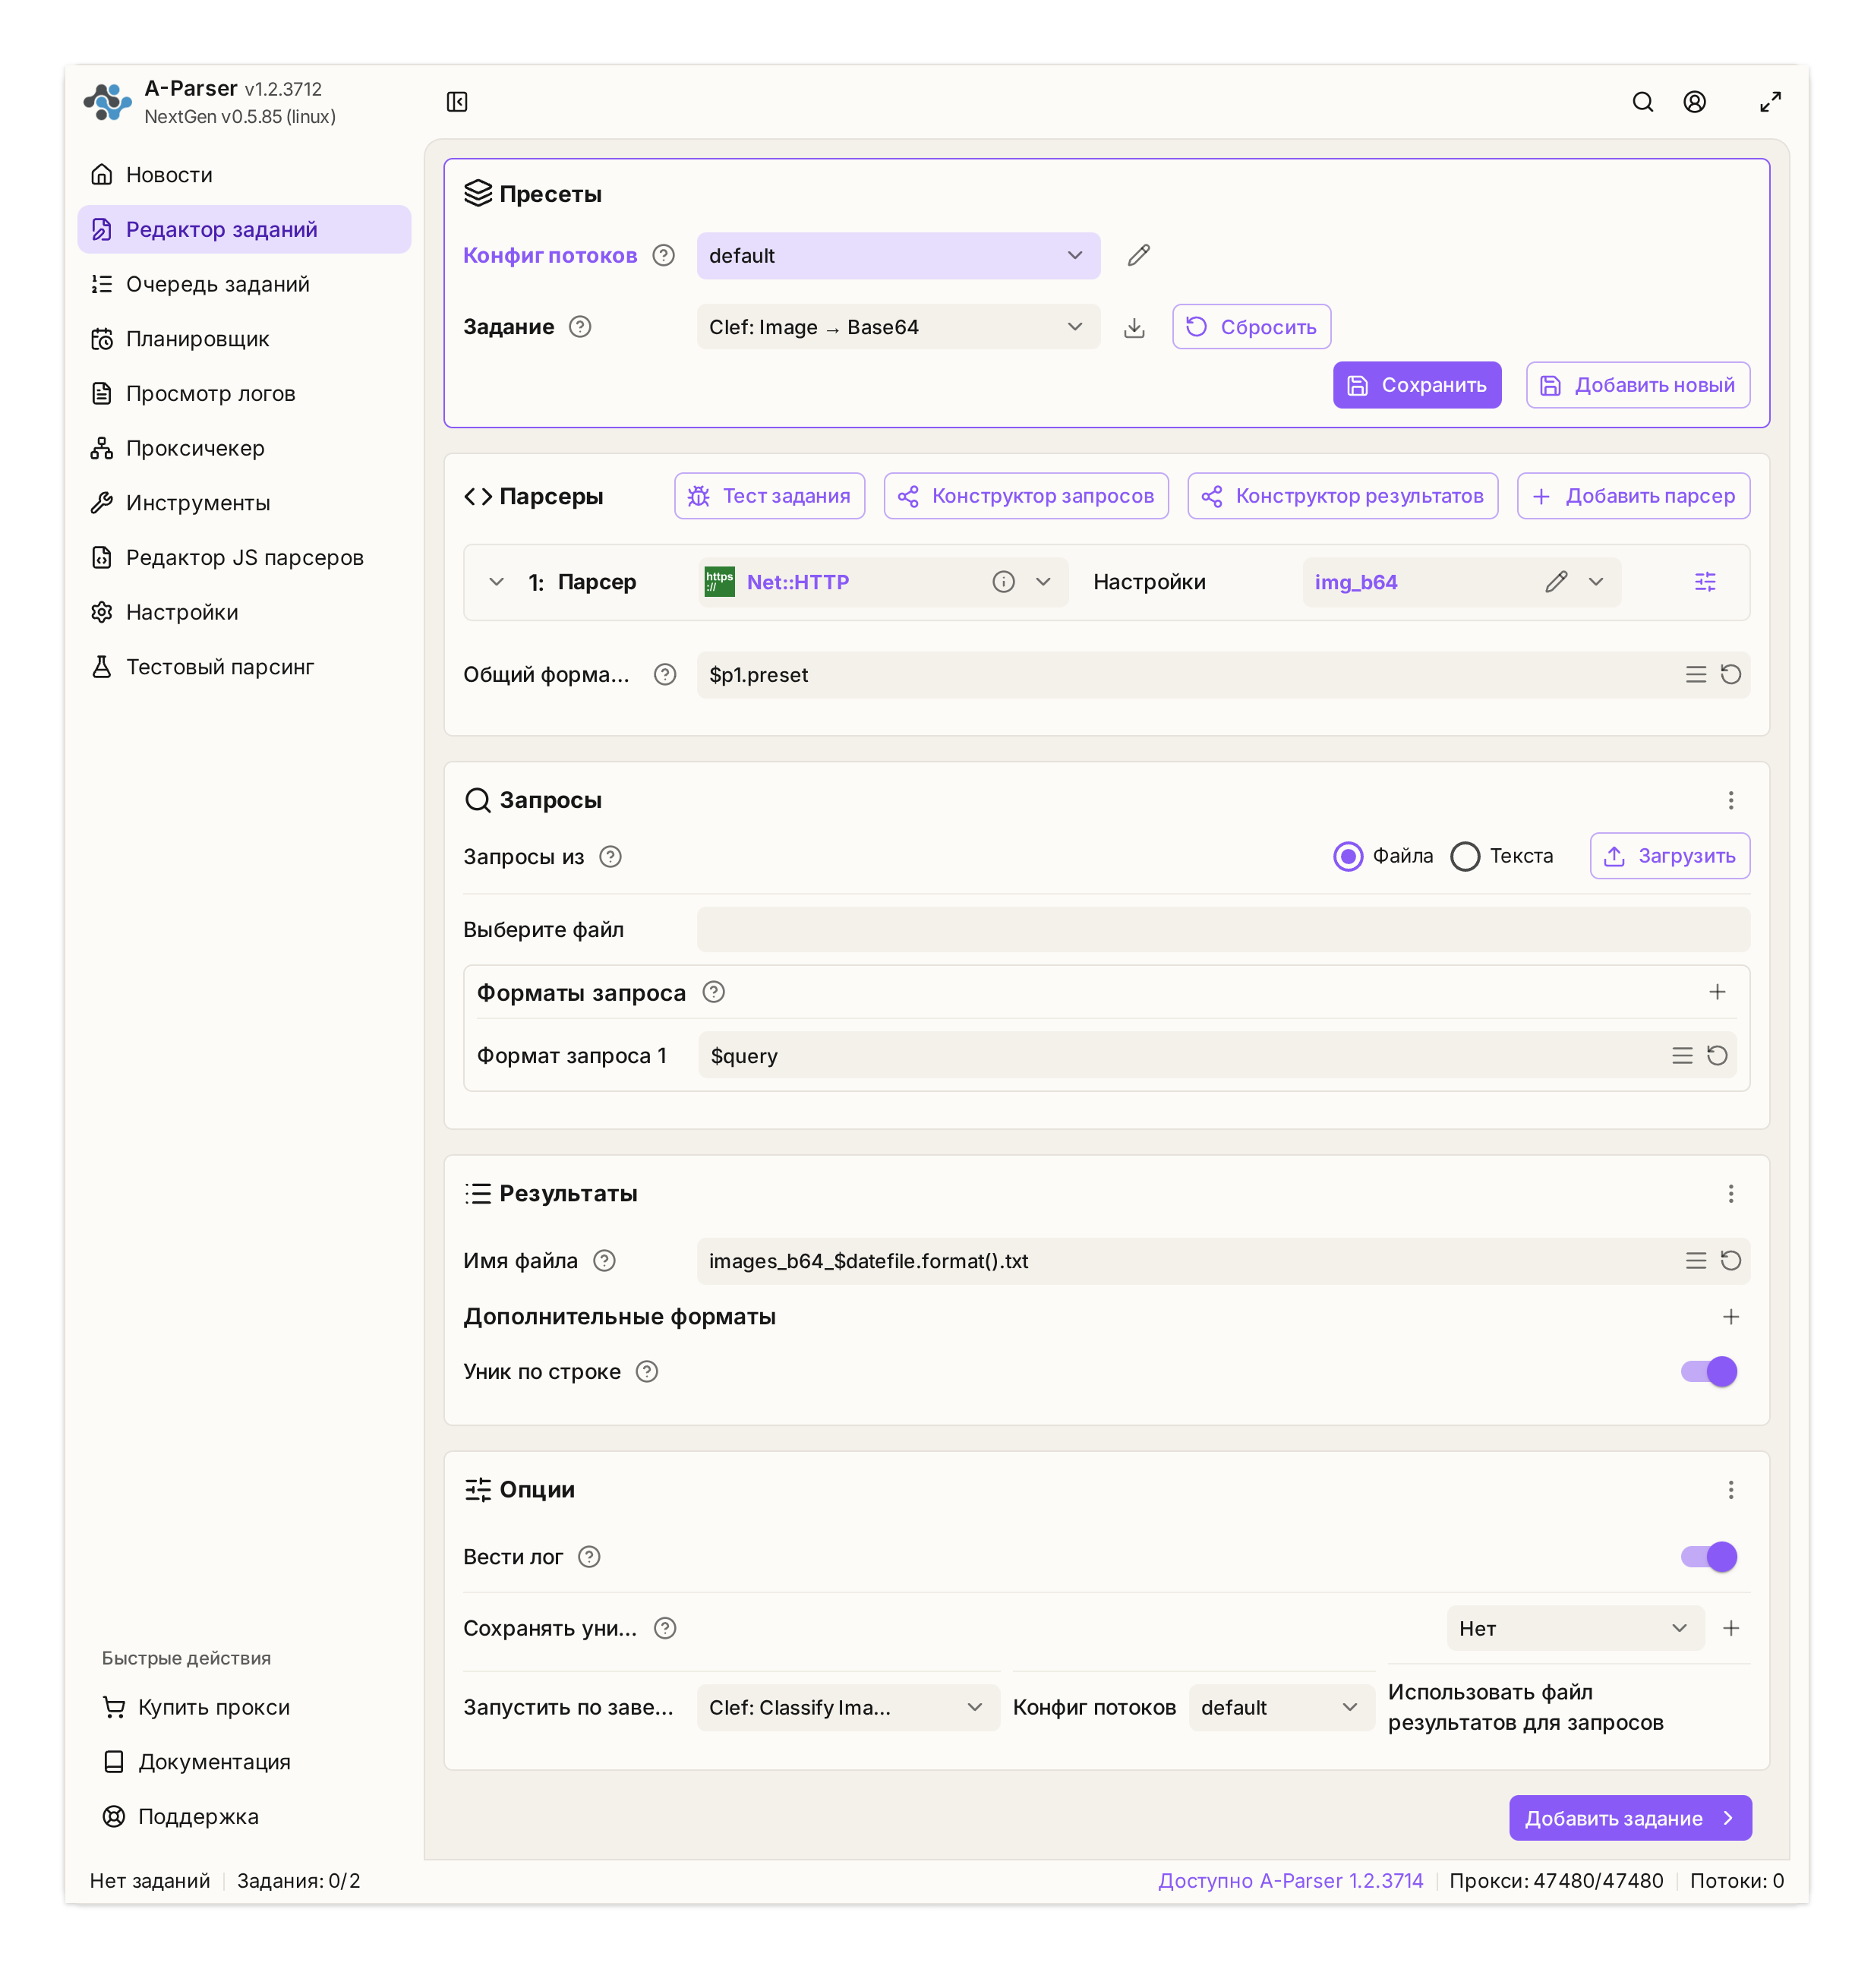
Задание 2 в редакторе A-Parser: Net::HTTP, получение запросов из файла результатов и запуск задания классификации после завершения.
Парсер:
Net::HTTP(пресетimg_b64).Прокси:
useproxy = 0(скачивание идет напрямую на полной скорости канала).Настройки надежности:
goodCode = 200,proxyretries = 10,requestdelay = 0,do_gzip = 1,max_size = 15728640(15 МБ).Имя файла результатов:
images_b64_$datefile.format().txt.Связка с Заданием 3:
runTaskOnComplete:Clef: Classify Image;useResultsFileAsQueriesFile:true(опция «Использовать файл результатов для запросов»).
Код формата результата (formatresult пресета img_b64):
[%][%][%]
[% IF h.match("^iVBOR") %][%][% ELSIF h.match("^UklGR") %][%][% ELSIF h.match("^R0lGOD") %][%][% END %]
[%][% query.orig %]@@[% t %]@@[% b %][% "\n" %][% END %]
Механика работы шаблона:
tools.base64.encode(data)— встроенная функция A-Parser конвертирует бинарный поток в Base64 прямо в памяти.h = b.substr(0, 12)— считывание префикса Base64. ПрефиксiVBORсоответствует PNG,UklGR— WebP, аR0lGOD— GIF.- Фильтрация GIF: Модели Clef не поддерживают GIF. Строка
[%]просто не передает GIF в следующее звено — строка отсекается, исключая заведомые ошибки API. - Защита от ошибки 422: Pinterest часто отдает WebP под расширением
.jpg. Распознавание по префиксу Base64 гарантирует, что API получит честный MIME-тип.
Что пишется на диск и сколько весит промежуточный файл:
- Бинарные файлы картинок на диск не пишутся: парсер
Net::HTTPне сохраняет скачанные изображения в папку как графические файлы. Тело ответа доступно шаблонизатору непосредственно в оперативной памяти как переменнаяdata, откуда оно на лету кодируется в Base64. - Файл результатов на диск сохраняется: итоговые строки
url@@mime@@base64штатно записываются в текстовый файлimages_b64_$datefile.txt, который служит очередью запросов для Задания 3. При необходимости из Base64-части любой строки можно восстановить исходный файл изображения без потери качества, используя указанный MIME-тип. - Расход дискового пространства: Base64 увеличивает объем данных примерно на треть. Перед крупной задачей заложите запас диска с учетом размера исходных изображений и текстового файла результатов.
FAQ: почему Clef не принимает картинки по URL
Естественный вопрос разработчика: зачем скачивать бинарник внутри A-Parser через Net::HTTP и кодировать его в Base64, если можно передать модели готовую ссылку на CDN Pinterest (https://i.pinimg.com/...) из первого задания?
Мы проверили передачу внешней ссылки на реальном пине с DIY-проектом (19c888...jpg). Результаты показывают, почему для надежной классификации нельзя передавать модели только URL: API либо отклоняет такой запрос, либо возвращает ответ, не получив пиксели изображения.

Эталонный замер через Base64 (как работает наш конвейер) Картинка передана внутри полезной нагрузки как встроенный data:image/jpeg;base64,... (77 КБ JPEG ➔ 102 КБ в Base64):
- Вопрос «Это футбол?»: вероятность 0.0094 (твердый ноль). Входных токенов: 1032, стоимость: $0.000039.
- Вопрос «Это DIY-проект?»: вероятность 0.9747 (твердая уверенность 97.5%). Входных токенов: 1049, стоимость: $0.000040.
Модель реально видит пиксели и дает категоричные, полярные ответы: 0.01 против 0.97. Токены стабильно держатся выше 1000.
Что происходит при попытке передать URL вместо Base64 Мы протестировали все возможные варианты передачи веб-ссылки в API OpenRouter:
Единственный честный отказ (формат
image_urlс URL):Моментальный ответ HTTP 400 за 0.09 с:
{"error":{"message":"Clef accepts only embedded base64 PNG, JPEG, or WebP data URL images","code":400}}Сервер Cloudflare прямо сообщает, что внешние ссылки не поддерживаются.Остальные 7 протестированных вариантов структуры возвращают HTTP 200 OK, но контрольные замеры показывают, что модель не получает пиксели изображения:
| Вариант структуры запроса | Вопрос «Это футбол?» (факт: 0.0094) | Вопрос «Это DIY?» (факт: 0.9747) | Токены (input) |
|---|---|---|---|
{"type": "image", "image": "URL"} | 0.1902 (завышение в 20 раз) | 0.2260 (отказ в очевидном) | 222 / 239 |
state: ["URL"] | 0.2092 | 0.2578 | 210 / 227 |
| Обычный текст с URL внутри | 0.1816 | 0.2295 | 213 / 230 |
Markdown-ссылка  | 0.2007 | 0.2146 | 216 / 233 |
{"type": "image", "image": {"url": "..."}} | 0.1924 | 0.2166 | 224 / 241 |
Формат OpenAI {"type": "input_image", "image_url": "..."} | 0.1735 | 0.2932 | 224 / 241 |
| Текст «Посмотри на фото по ссылке и ответь» | 0.5322 (50/50) | 0.5102 (50/50) | 224 / 241 |
Почему HTTP 200 не подтверждает обработку изображения
- Модель получает текст ссылки, а не изображение:
На вопрос про футбол модель вместо 0,0094 дает 0,17–0,29, а на вопрос про рукоделие вместо 0,9747 — около 0,20. При прямой просьбе «посмотри на фото по ссылке и ответь» значения оказываются около 0,51–0,53. Без визуального входа эти ответы нельзя использовать для классификации изображения. - Счетчик токенов (
usage.input_tokens) помогает обнаружить проблему:
В запросах без встроенного изображения он находится в диапазоне 210–240 токенов, а стоимость составляет $0.0000085. При передаче Base64 число входных токенов превышает 1000, а стоимость составляет около $0.00004. Такая разница служит практическим индикатором того, что модель получила визуальные данные.
Главный вывод: В протестированных вариантах прямая веб-ссылка либо приводила к ответу 400, либо возвращала HTTP 200 без передачи пикселей в модель. Поэтому в этой связке изображение сначала скачивается через
Net::HTTP, кодируется в Base64 и только затем отправляется в API.
Задание 3. Net::HTTP — отправка в Clef через OpenRouter Decisions API
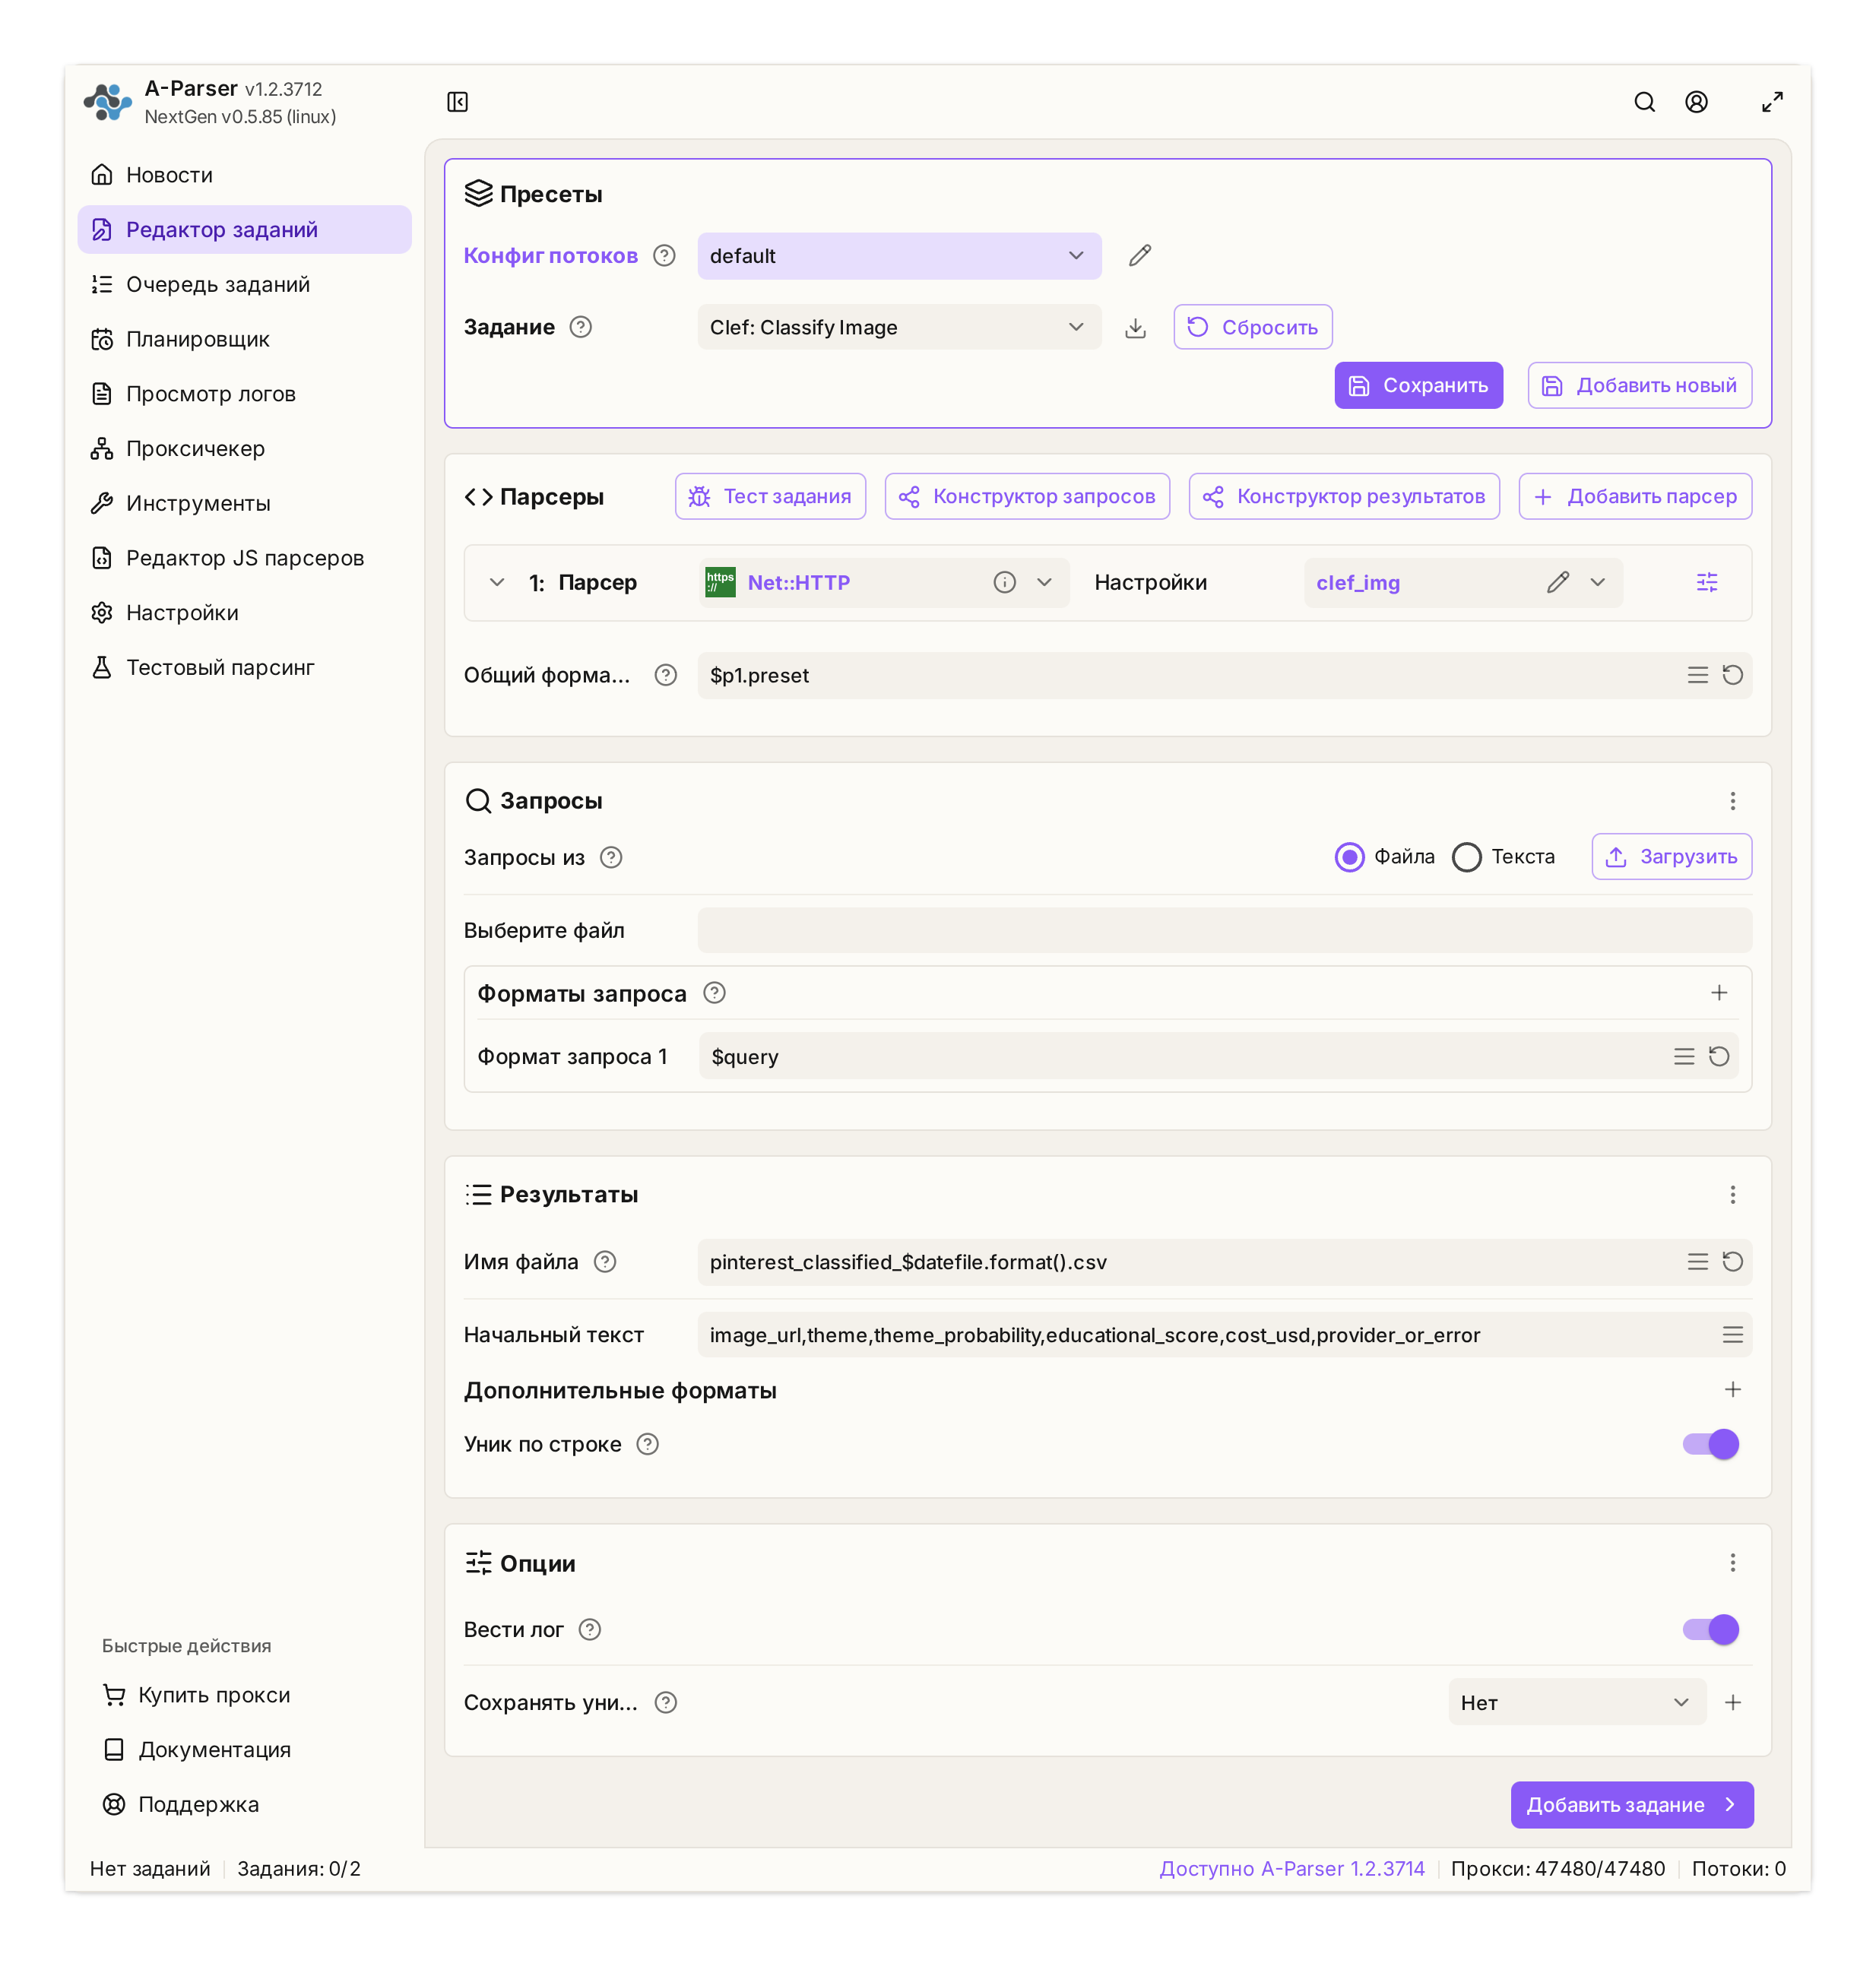
Задание 3 в редакторе A-Parser: Net::HTTP, запись результата в CSV и поля ответа классификатора.
- Парсер:
Net::HTTP(пресетclef_img). - Формат запроса (Query format):
https://openrouter.ai/api/alpha/decisions - Метод:
POST - Прокси:
useproxy = 0. - Настройки ретраев:
goodCode = 200,proxyretries = 10,timeout = 60,do_gzip = 1. - Заголовки: рабочий ключ не хранится в пресете
clef_img. После импорта откройте задание «Clef: Classify Image» → «Действия парсера» (Parser actions) → «Добавить переопределение» (Override preset) → «Дополнительные заголовки» (Additional headers). Галочка уже установлена; заменитеYOUR_OPENROUTER_KEYв первой строке своим ключом; оставьте обе строки заголовков и не добавляйте приставкуHTTP::
Authorization: Bearer YOUR_OPENROUTER_KEY
Content-Type: application/json
В публичном пресете переопределение заголовков уже включено, но вместо рабочего ключа стоит заглушка YOUR_OPENROUTER_KEY.
Как обрабатывать 429 в
Net::HTTP:
ПолеgoodCode = 200отмечает код 200 как успешный, поэтому ответ 429 считается неуспешным и может быть повторён до 10 раз (proxyretries = 10). По документации OpenRouter, 429 может вернуть сама платформа (лимиты free-моделей или DDoS-защита) либо апстрим-провайдер при ограничении или нехватке мощности.
Документация не раскрывает, привязана ли DDoS-защита к IP, ключу или сочетанию сигналов. Ротация IP поэтому не является универсальным решением: она не увеличит квоту модели и не устранит ограничение провайдера. Для диагностики смотрите заголовкиX-RateLimit-*у платформенного 429,error.metadata.provider_codeу ответа провайдера иRetry-After, если он передан.
Динамическое тело POST-запроса (POST Data): Шаблонизатор Template Toolkit динамически подставляет тип и тело Base64 для каждой картинки:
{
  "model": "cloudflare/clef-flash",
  "provider": {
    "only": ["Cloudflare"]
  },
  "state": [
    "Pinterest pin photo attached for classification.",
    {
      "type": "image_url",
      "image_url": {
        "url": "data:image/[% query.orig.split('@@').item(1) %];base64,[% query.orig.split('@@').last %]"
      }
    }
  ],
  "questions": {
    "theme": {
      "type": "choice",
      "instructions": "What is the primary subject and category of this image?",
      "options": [
        "interior_design_home",
        "sports_football",
        "food_drink",
        "fashion_beauty",
        "diy_crafts",
        "educational_diagram",
        "travel_places",
        "meme",
        "halloween",
        "other"
      ],
      "criteria": {
        "interior_design_home": "Room interiors, furniture, living rooms, home decor, architecture",
        "sports_football": "Football match, soccer players, stadium, ball, jerseys, sports action",
        "food_drink": "Food dishes, healthy meals, baking, drinks, recipes, cooking process",
        "fashion_beauty": "Clothing outfits, style, makeup, hairstyle, manicure, nail art, accessories",
        "diy_crafts": "Handmade crafts, DIY projects, woodworking, handmade items, tools in use",
        "educational_diagram": "Infographics, explanatory charts, diagrams, step-by-step educational guides, instructional text posters",
        "travel_places": "Landscapes, travel destinations, scenic cities, nature, landmarks",
        "meme": "Internet memes, humorous image macros, funny reaction images, jokes, relatable social media humor",
        "halloween": "Halloween costumes, cosplay outfits, pumpkin carving, jack-o-lanterns, spooky decor, trick-or-treat, horror makeup, ghosts, witches, skeletons",
        "other": "Miscellaneous images, out-of-context personal selfies, software screenshots, abstract textures, uncategorized collages"
      }
    },
    "educational": {
      "type": "noul",
      "instructions": "Is this image educational, instructional, or an infographic explaining concepts?",
      "criteria": {
        "true": "Infographic, tutorial, guide, or diagram that teaches, explains, or demonstrates steps",
        "false": "Pure aesthetic photo, product visual, meme, lifestyle shot, or non-educational image"
      }
    }
  }
}
Использование оценки обучающего контента в шаблоне
В ответе API поле educational.noul содержит число от 0.0 до 1.0, а не строку «да/нет». Поэтому по нему можно сразу фильтровать результаты в шаблонизаторе A-Parser:
Пример ветвления: записывать в CSV метку для обычного изображения или обучающей инфографики по значению оценки.
[% IF j.answers.educational.noul < 0.2 %]
  [% tools.CSVline(query.orig.split('@@').first, j.answers.theme.choice, "PRODUCT") %]
[% ELSE %]
  [% tools.CSVline(query.orig.split('@@').first, j.answers.theme.choice, "INFOGRAPHIC") %]
[% END %]
Обработка ответа и запись в CSV (formatresult пресета clef_img):
[% TRY %]
  [%]
  [% IF j.answers %]
    [% tools.CSVline(query.orig.split('@@').first, j.answers.theme.choice, j.answers.theme.probabilities.item(j.answers.theme.choice), j.answers.educational.noul, j.usage.cost, j.provider) %]
  [% ELSE %]
    [%]
    [% tools.CSVline(query.orig.split('@@').first, "ERROR", 0, 0, 0, msg) %]
  [% END %]
[% CATCH %]
  [% tools.CSVline(query.orig.split('@@').first, "PARSE_ERROR", 0, 0, 0, tools.error) %]
[% END %]
Важное замечание: во всех трех заданиях поле «Формат результата» оставлено дефолтным ($p1.preset), поэтому реальный вывод целиком определяется пресетами парсера (img_b64 и clef_img).
Ошибки и ограничения при настройке A-Parser и Clef-Flash
Настройка и практические тесты вскрыли 5 нюансов, о которых молчит официальная документация:
- Разделителем нельзя использовать символ пайпа
|:
В Template Toolkit символ|зарезервирован под фильтры. Вызовquery.split("|")режет строку посимвольно. Разделитель@@работает стабильно. - Строгая фиксация апстрима (
"provider": {"only": ["Cloudflare"]}):
В пуле OpenRouter модельclef-flashхостится несколькими провайдерами (Cloudflare, DeepInfra, Prime Intellect). Сторонние апстримы возвращают400 Bad Requestпри передаче картинок вstate. Директиваprovider.only: ["Cloudflare"]гарантирует стабильность. - Два независимых лимита модели: декодированный объём и разрешение:
Это два разных отказа API: PNG размером 5,4 и 5,1 МБ при умеренном разрешении возвращалиimage exceeds the decoded byte limit, а JPG объёмом 2–3 МБ с разрешением 17–35 мегапикселей —image dimensions are too large. Картинка объёмом 4,2 МБ в Base64 при 1080×1920 прошла успешно. Практические границы наблюдений: 4,2–6,7 МБ Base64 по объёму и 4–17 мегапикселей по разрешению; это не гарантированные лимиты API. - Полная несовместимость с форматом GIF:
Clef не поддерживает GIF вовсе. Если не отфильтровать его по сигнатуре Base64 (R0lGOD), он уходит под маской JPEG и возвращает422 payload does not match its content type. В нашем пресете GIF отсекается еще на этапе кодирования. - Ретраи при 429:
УкажитеgoodCode = 200иproxyretries = 10. Тогда A-Parser повторит любой ответ, отличный от 200, включая429 Too Many Requests, до 10 раз.
Где применять парсинг и классификацию изображений Pinterest
- Сезонные кампании к Хэллоуину:
Запросhalloween costumesбыстро собирает референсы костюмов, грима и групповых образов. Добавленный в схему классhalloweenотделяет их от обычной моды, мемов и DIY, поэтому сезонную базу проще использовать для витрин, email-рассылок и рекламных креативов. - E-commerce и товарные каталоги:
Сбор трендовых товаров и предметных фото. Автоматический отсев нецелевого визуального шума и мемов: в итоговую базу попадают только чистые предметные фотографии товаров без необходимости отсматривать тысячи картинок глазами. - Арбитраж трафика и создание креативов (Pinterest Ads, FB Ads, TikTok):
Категорииmemeиfashion_beautyпомогают быстро отобрать примеры визуальных приёмов для исследования и последующей адаптации креативов в Facebook Ads, Instagram Reels и TikTok. - Контент-маркетинг и экспертные блоги:
Автоматический отбор обучающих схем, чертежей и чек-листов по порогуeducational > 0.80. Это готовый иллюстративный материал для наполнения экспертных лонгридов и PBN-сеток, где пошаговая инфографика дает максимальное удержание внимания и глубину просмотров. - Пакетная разметка любых медиатек:
Потоковая сортировка крупных медиатек по 10 категориям. Архитектуру можно адаптировать к другому источнику картинок: файлам из локальной папки, выгрузкам из Google Images или каталогам поставщиков. Стоимость обработки следует оценивать по объёму и типу конкретной выборки; в текущем тесте она составила $0.0000528 за успешную классификацию.
Готовый пресет A-Parser: импорт и запуск
Ниже — экспортируемый пресет A-Parser для цепочки из трёх заданий и десяти категорий, включая halloween. Рабочего ключа в нём нет: после импорта добавьте свой ключ OpenRouter через переопределение заголовков в третьем задании.
Как запустить
- В разделе «Редактор заданий» (Task Editor) нажмите маленькую кнопку без подписи сразу справа от поля «Задание» (Task preset), рядом с кнопкой «Обзор пресетов заданий» (Browse task presets) и левее кнопки «Сбросить» (Reset to default) → выберите «Импортировать пресет» (Import preset).
- На шаге «Вставьте пресет или URL» вставьте base64 и нажмите «Далее» (Next). На шаге «Выберите элементы» мастер пометит
img_b64,clef_imgиpinterest_usaтекстом «Перезапишет существующий пресет парсера»; это ожидаемо — нажмите «Далее» (Next). На шаге «Выберите категорию» нажмите «Импорт без категории» (Import without category). - В задании «Clef: Classify Image» нажмите «Действия парсера» (Parser actions) → «Добавить переопределение» (Override preset) → «Дополнительные заголовки» (Additional headers). Галочка уже установлена; замените
YOUR_OPENROUTER_KEYв первой строке на свой ключ, оставив обе строки и не добавляя приставкуHTTP:; сохраните изменение. - Запустите задание «Pinterest → Image Links». Остальные два стартуют по очереди автоматически; на выходе — CSV с результатами.
Показать код пресета для импорта
eJztWntz27gR/yooJzexb2j5cXncqNOpHcVOfHUsV7bTyViuBiJBERZJsABo
W/Ho3/sA/Yj9JP0t+JBky8k1vbSXG83cgwAWu4t9/LAL6867FtpIlXntbd+z
3IzNiRZGWOO1L+683H17be9EZlZgYNm/fv4nO0z5SLAjmY2N53s51wZMsOHC
O91vtxtaWqu/B4Xhnn/n2UkuwE9BrJahAIkMMc61up10YhGMhcbcNU8KIgtF
xIvEetPLS98DG3ybA6VTTjo9ybdblYLN4im/FmcKi5FMxGz6AKNjnhLLmUaS
TmEGT0JuBZG3Isd5bb1lb4klD0NpYRqelCLphDM1zjP5D6ejsVpmI9BjqKUw
B1qlmLbCMaHJSa3yhffEjT2wKdz+v5Z7vHbEEyN8z0D/Aw5lwvsrElpzq3Q3
J50wf+epbC9JjsS1SGZkjv+rQiYhXLIXYdNhtXE5SfcBj2lzxHlR8NeNhg4N
Fzd61X032xWqIzUipw1x7kSm0mJsOqrIcPQt3xsLkTdWO1YgSpUWjZCKbyUb
UZiLjEJj5sW9fDa1cIgFxyxOBiqL5KhbhVtNWWRnCPVu1lFpngg6lddJRNSu
Ipti/BU34sUzSCqM6M2iaM9UjqGB17a6EEv4dZzUuQBGbimVmJ9OS+1zLRGk
z0nnFKadV6QyQ8CT5Lx3tKAiNhqr8m62r/U9f7pI8WKVChaKQOl+Fillh2DS
z2LBExtP2FALPo64sf1MFTaSlsEi3PSzUE5YoHlk8S2xcaR5HssAO7Ff3QiR
sUAZW6QCBFGRZROWCgzmYt4Zw9kbyTRSCHGMpv4cgjxq33n4OBa23X57dnZC
uJCOBkOieBQ0ynwt3T4HGhffsSH7E3MGbw2dmJbIAhWKNaQ6X2ffXYIkBsmw
ZYoh8ndty2fbO9WCxULfu8rFqO+VM4cHLG5BUhCv9b2/y/evur2+t0CdZw3x
/tHpIv35OHlzn/5GDPNHN/S2kjfd1/d2jGTUbDh+3ehl2R/urbrEaCktRxjv
7joG1cewpOh7/X62yMybPm7lkVJhR7lxZeGLna2ty0/sSPntwMiPczu87ecv
d3588Wzr10TyCr8RI18LwyvRKwz/pjC8k3BjZDQpwebbQvAvgNQHx30MUAOQ
o+gZfQJRcVU4s88Sd6+wMcDkIycPt9krwbXQ7EP3vDfonuwf97rnZ/u9wV/2
P/RxTlRWmd04A+8243meyMBt27wyKDA/ARiPA/lZ70OJU1cNorvj/XTaPZ5H
c0DhVYtn5gbaV7DpiDun7xOZibUZKrYM9LLA2d1dQGwrktpYf7a5ZWNcba0g
VjIQD+dRpw75UIIDXNRC9qRry7euz+8VYVFagict3L0JraEeHoFYldLB9xoG
0evNnbBffqVmhJNftQQFTAuXLm37khP2vf1ejy4un23V/4D5+r07pbN31nn7
ZfxP9nqn+4OHUko+7gDrv/TScdLKsJgLiNja3LQ3NxUwRKOGEbrF5SbP8W+S
x3wTpY80Dok+wXqowskcz7s+ICwUSd9r4wxBooowShDkm5QuG/g0MZ2m79Uu
IkJsUlkyoc+LPvKw3tT3kKGgNRY5W63OWie0HiyPlVWMW8uDWIQMR2RBmcBV
srRIGviT9qVO7p4bFDop9ZgbOkWqr75H6dB2q5sLdUDlr6e7u0/Xy5DdJj/8
sSyN/MdpoRfVDn1vOr0kySAzDugryS7e6+9G3TL+K10z3KxF0Gzqe3+LOepO
w7CXAUNTricMRdiVCCzjWchqsGMqAg0I3YH+XLJTecPpgpjDrlLpAe4EOcoG
VP2WdCZX2ppBUwK7SYzCQYh7flyN4VlwGwwFL+yknEMlPKgqYTeeS9xBKDkK
47RcsBqXfDLIEx6IijYVtfimbK60xlkRNc6EAd24WvLKasuPQHbqKZWyetn4
LCp0Jm2hgUmJvEaxwjQosDCr+X3GdRCDf0B0j1iCeB9UI+ZKTp8ZFQQAdRxm
IkgWojeUReozIgI6YVJMaN4xY9z586FRK9YhC6WJBalWNR4p/m+I2xh6+8yR
Y6yRrTnRBUrRCuJBwZpmuXuIOxINMQHKsn9xqk4SmCTlY1HkkMgJjKqpTAbO
XhlqMZgGGMUD4q/oen3obxLwFiGY4gqs2iGfvT78QGpReGJ0g9PdKF0eI65p
KaVMBXNwGUO58YnoITGHsyYLG8UtLJ9ReYc2LIaimKvI3QlFvjGcbND/2RxH
NiqoGPLZXI5hlp4dWI5bBU5bGqok/wiqm4A745fLiCCkduZ4k9BAwHoscNcc
WbCKPHdkPTYP4rw03v1ukVxrKKxmDsuLNIf9kOf62pnxigfjDbUB1lA5K6NM
jSd1SKMwp3W9gfKAWwp3ukcah49iiCLPSEQyCTRjgVrLgcQsKUubE39hy9YV
jApUrqqoAAYMA61cnlF7C1nOoOUipq/UWLiQTQCyw0RQzkiYOxXwVMlrIdlJ
4jsJMyY4mGjEgAUssaGijYCKJXIV/OQcZ0QSOWMbFdkb3CVwgoYxDS4MzHLq
U6GUczCcgakiq8ASrRaAU0HUiDw8nd4LvgcQTTXIYwB9aOZwdz7g7kUaTqKB
2GzuwaCMZJlRhuJ8gcitqZD7Hu5R0f0gFeDsAkkgibcLbieiygQoxenwvHRz
JcmUJCjBSTVYw7h8aSAkMZWYE5iMccR4LCwUdbewT5mN81l2LU1BUik0CF8j
4UCEke2dhExlG/O554xDlp5Ov87bZF0TiHBZbxuY61Vv+1vpbZt6zHf1UPnf
waxRmPjz94ABqgmfAHJQmNCvi8oBagBXIfez/1Gv/Lm+uD7ut9IYXzaNb/MH
jLu59heDpv/Fd/2o1RMjcVuyp943QXnQCB9qdQN+9RNBpOh6g84Amx5gX1NN
0Lwf4GZUKYB4YBOUW0g4oWEJiqyKm5Up7gHChhdbFFr8tkNljzvc9ovSG+6v
IM2OUuA7YXlPRDhTXAuj1qPu1BtlJzkQw3UiB9SJdGKkuXjHb0/oUoCMHZJq
9WRATdR2zSoU1857DR+ngha2Mvv2lgtHV/mjSeLQzqOphY591an/3jt1ChTq
K6g8dW9PVbSIbASJVWfuIgUlt6GJl4SxagS0yESwiKDN8zCF17Mfn7+sol9v
wGCUMQ3eRfV1+ssbf795w/o1366ATmOZnx2dvgcERbMUJb12PpODbxtcKVOu
eU8v39H9xb99tr3vIe2GS3ueWZlgjJrV9RxgsoMl93yxerZYPVusni1Wzxar
Z4vVs8Xq2WL1bPEFzxbUDw9GH2Ve1yXLq5dZ1SZQTFEzetI9PaO/Jjbdi1eV
MEOOWi9E/cGzAly9H7aoU8DsQqM1nf2y4//chz37XfZhq5++/Ic/fflqvU39
k5fPNTfVm9t85/IbbDi+HDDe7P9XeAHAWPxVKWBj8WelmHjEorh0NC8HpVw4
ISgf/J4vz7F7tpk9ci1JvqWneLG1JC+fIADy+v326ZMSh/vZ03XvwcPQDH7I
ylM6/pU5KV+26OmL3rWm038DkdYUWg==
Полезные ссылки и следующий шаг
- Выбрать A-Parser Pro или Enterprise
- Документация A-Parser
- Документация парсера Pinterest
- Подключить A-Parser Premium-прокси
Для первого запуска замените тестовые запросы на свою нишу и проверьте первые 20 строк CSV: ссылки на изображения, категории и оценки. Если результат соответствует задаче, увеличивайте объём выборки.