
Ваш бренд есть в Google. А что о нём говорят ChatGPT и AI-поиск?
«Ссылки — это прошлый век, теперь все решает AI-оптимизация» — фраза, которую за последний год повторил каждый второй маркетинговый спикер. Однако если попросить спикера показать формулу ранжирования нейросетей, начинается абстрактный туман: «делайте полезный контент, внедряйте Schema.org и ждите».
За общими советами об AI-оптимизации уже можно увидеть конкретные данные. Ahrefs сопоставил сторонние упоминания 10 000 брендов с их присутствием в ответах нейросетей. Semrush и Кевин Индиг изучили, когда ссылка на сайт сопровождается названием бренда. А Peec AI исследовал, откуда ChatGPT получает товары для своих подборок.
Из этих работ складывается несколько важных выводов:
- О бренде должны говорить не только на его собственном сайте. Ahrefs обнаружил сильную связь между сторонними упоминаниями и AI-видимостью; наиболее выраженной она оказалась у обсуждений Reddit, которые ранжируются в Google.
- Ссылка и упоминание — разные результаты. Нейросеть может использовать ваш сайт как источник, не назвав компанию. Или назвать продукт без ссылки, и такое появление бренда не будет видно в отчёте о переходах.
- У товарных рекомендаций есть связь с Google Shopping. Peec AI нашёл более 83% товаров из изученных каруселей ChatGPT среди первых 40 органических результатов Google Shopping и обнаружил технические признаки использования этого источника.
При этом картина различается по отраслям. В исследовании DataForSEO AI Overviews встречались у 75% изученных финансовых запросов и у 39% запросов о недвижимости в англоязычной выдаче США [17]. Поэтому важнее проверить выдачу по вопросам своих покупателей, чем ориентироваться на среднюю температуру по рынку.
Разберём, как нейросети используют внешние источники, что это означает для бренда и как организовать регулярный мониторинг в A-Parser.
1. Откуда нейросеть берёт информацию для ответа
Покупатель спрашивает: «Какую CRM выбрать для небольшой компании?» Чтобы ответить, нейросеть может использовать не только сведения, усвоенные при обучении, но и найти свежие обзоры, сравнения и страницы продуктов в интернете.
Такой подход называют RAG (Retrieval-Augmented Generation): система сначала находит подходящие материалы, а затем использует их при составлении ответа. На результат также могут влиять доступ к материалам издателей и контекст разговора — например, бюджет покупателя или требования к интеграциям.
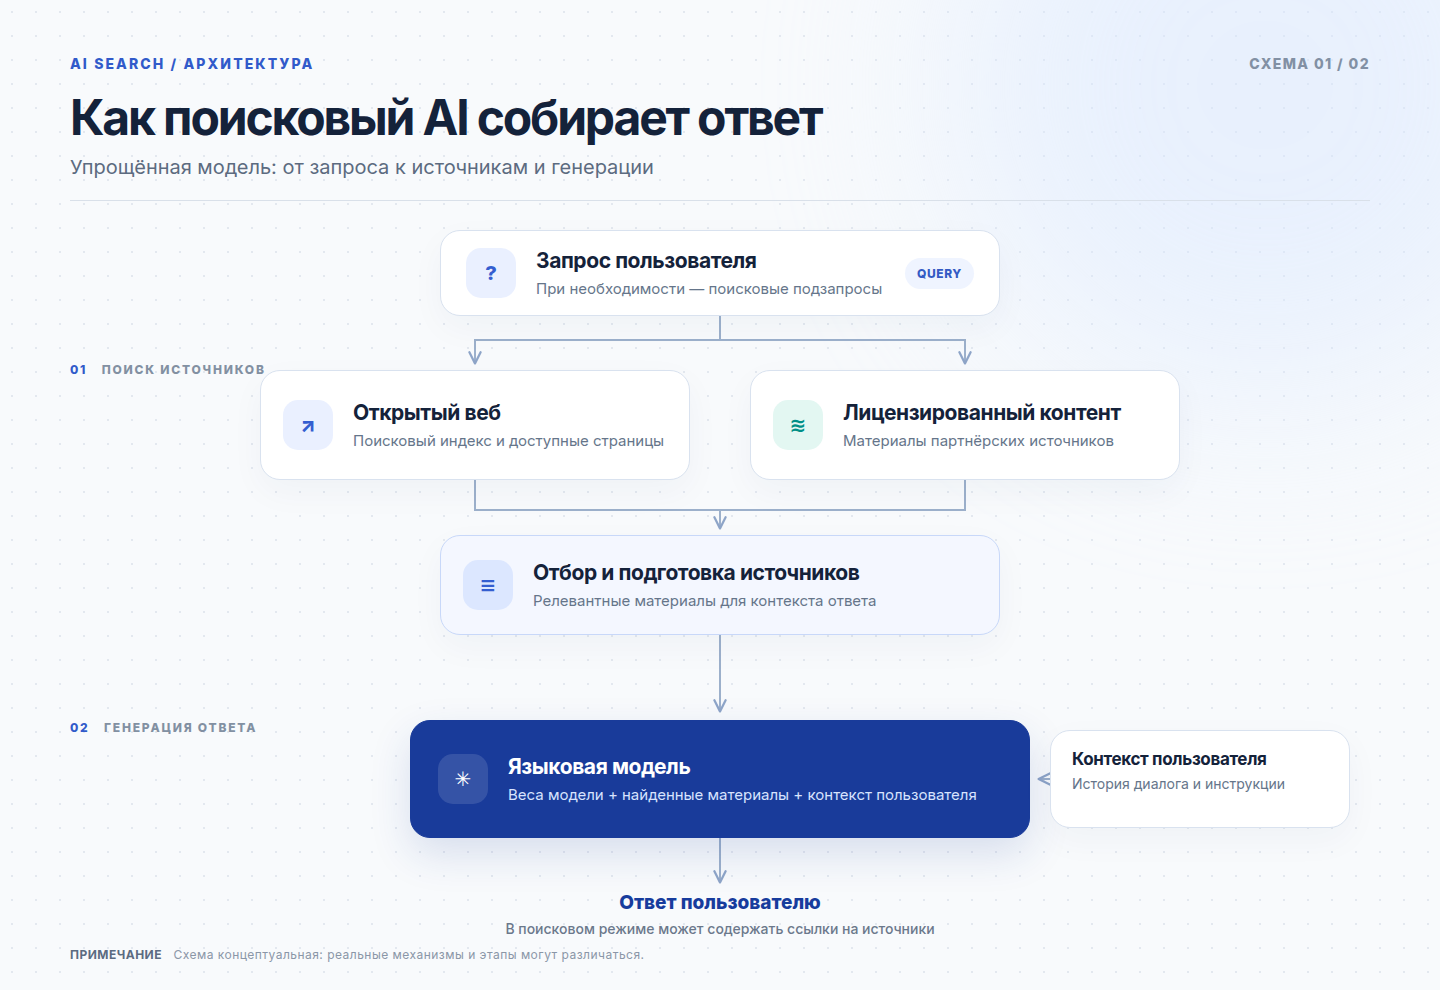
На схеме показан общий принцип. Конкретные способы поиска и отбора источников различаются у разных сервисов. Один вопрос пользователя может запускать несколько поисковых подзапросов — это называют Query Fan-out.
Какие данные могут участвовать в ответе
| Источник данных | Что включает | Как используется | Что это значит для бренда |
|---|---|---|---|
| 1. Сведения, усвоенные при обучении | Тексты сайтов, книги и другие материалы из обучающей выборки. | Формируют знания модели и связи между понятиями, в том числе брендами и категориями. | Это не оперативный канал обновления: новые сведения на сайте не меняют уже обученную модель. |
| 2. Поиск в интернете | Страницы, найденные через поисковые системы и доступные поисковым роботам, например OAI-SearchBot. | Помогают находить актуальные обзоры, сравнения, цены и характеристики. | Важны присутствие в поисковой выдаче и доступность нужных страниц для роботов. |
| 3. Материалы издателей по соглашениям | Контент партнёров, включая Condé Nast, Hearst, Future и Axel Springer. | Может использоваться в ответах в зависимости от запроса и условий соглашения. | Стоит проверять, какие обзоры и сравнения цитируются по запросам покупателей и представлен ли в них ваш продукт. |
| 4. Контекст разговора | Запрос, предыдущие сообщения, пользовательские инструкции и загруженные файлы. | Уточняет задачу: бюджет, отрасль, нужные функции и другие условия выбора. | В мониторинге важно учитывать разные сценарии выбора, а не только один общий запрос о категории. |
Практический вывод: Проверяйте не только собственный сайт, но и внешние материалы, на которые ссылается AI-поиск по вопросам ваших покупателей. Есть ли там ваш продукт, как его описывают и с кем сравнивают? Это поможет понять, какую информацию о бренде нейросеть может использовать в ответе.
2. Кто говорит о брендах: Reddit, форумы и другие площадки
Фраза «Упоминания — это новые ссылки» стала одной из самых обсуждаемых в дискуссиях об AI Search. Но какие именно упоминания статистически связаны с выдачей нейросетей?
Лаборатория Ahrefs провела масштабное исследование 10 000 американских брендов на массиве из 260 миллионов небрендовых поисковых запросов, сопоставив частоту появления бренда в ответах трех платформ — ChatGPT, Google AI Mode и AI Overviews — с его присутствием на различных внешних площадках [1].
Методология исследования Ahrefs:
- Выборка: 10 000 брендов США (названия от 5 символов, очищенные от омонимов и имен собственных) и 260 млн небрендовых промптов (запросы, содержащие само имя бренда, были исключены).
- Что измерялось: Упоминания бренда на сторонних ресурсах, которые бренд не контролирует (через Ahrefs Content Explorer с исключением собственного сайта компании и страниц с нулевым трафиком).
- Метрика связи: Ранговая корреляция Спирмена (Spearman rank correlation) как объединенная оценка по всем трем платформам (ChatGPT, AI Mode, AI Overviews). Чем ближе значение к 1, тем чаще бренды с большим числом упоминаний занимают более высокие позиции и по AI-видимости.
- Важный дисклеймер авторов: Корреляция фиксирует статистическое совпадение порядков ранжирования, но не является весом в алгоритме и не доказывает причинно-следственную связь. Нельзя утверждать, что искусственная накрутка упоминаний вызовет гарантированный рост рекомендаций в LLM.
Объединенная корреляция Спирмена по типам сторонних упоминаний
Ahrefs сопоставил семь типов сторонних упоминаний с объединенной частотой появления бренда в ответах ChatGPT, Google AI Mode и AI Overviews:
| Тип стороннего упоминания бренда | Корреляция Спирмена |
|---|---|
| Reddit: ветки, которые ранжируются в Google | 0,75 |
| Сторонние веб-страницы с упоминанием | 0,70 |
| Суммарный трафик упоминающих страниц | 0,70 |
| Уникальные домены с упоминанием бренда | 0,70 |
| Публикации в новостных медиа | 0,67 |
| YouTube: упоминания в транскриптах | 0,64 |
| TikTok: упоминания в описаниях и транскриптах | 0,60 |
Примечание к данным: В исследовании Ahrefs для Reddit учитывались любые треды, присутствующие в поисковой выдаче Google по целевым запросам (а не только первая десятка). Значения 0,70 у доменов, страниц и трафика показывают одинаковую силу связи, а публикации в прессе (0,67) показали чуть меньшую корреляцию с выдачей AI, чем общее упоминание на нишевых сайтах (0,70).
Что показало сравнение брендов: нелинейная связь веб-упоминаний
Исследование зафиксировало, как соотносятся сторонние веб-упоминания и частота появления в ответах AI у изученных компаний:
| Число сторонних страниц, упоминающих бренд | Медианное число упоминаний в ответах AI | Динамика масштабирования |
|---|---|---|
| 1 000 страниц | ~73 упоминания | Базовый ориентир выборки |
| 10 000 страниц | ~273 упоминания | При росте сторонних страниц в 10 раз — упоминания в AI выше в 3,7 раза |
Что показывают цифры:
Разрыв между 1 000 и 10 000 внешних упоминающих страниц огромен (9 000 сторонних публикаций в сети), однако статистическая разница в ответах AI составляет лишь ~200 упоминаний. Рост числа сторонних веб-страниц демонстрирует затухающую зависимость.
В то же время по Reddit зафиксирована более выраженная связь: бренды, имеющие в 10 раз больше упоминаний в ранжирующихся ветках Reddit, в среднем получали в 5,5 раз больше упоминаний в ответах нейросетей. При этом типичный (медианный) бренд в исследовании имел всего 8 тредов на Reddit с упоминанием своего имени, а 29% брендов не имели ни одного.
Возможные причины высокой корреляции Reddit с AI-выдачей
Хотя исследование Ahrefs фиксирует наблюдаемую статистическую связь, а не формулу алгоритма, эксперты поисковой индустрии выдвигают две ключевые гипотезы:
- Прямые партнерские соглашения: И Google, и OpenAI заключили официальные коммерческие договоры с Reddit на использование его контента для обучения моделей и поискового индексирования.
- Гипотеза о ценности реального опыта (First-Hand Experience): В условиях обилия программного SEO-контента обсуждения в сообществах служат для алгоритмов естественным фильтром, где реальные пользователи делятся личным опытом, сравнивают альтернативы и открыто обсуждают недостатки продуктов.
Почему доступ к данным Reddit становится сложнее
Reddit ограничивает неавторизованный сбор данных: в 2026 году перестали работать неавторизованные запросы к публичным .json-адресам [8], а платформа объявила о прекращении поддержки публичных RSS-фидов [7]. Поэтому привычные способы автоматического мониторинга обсуждений могут перестать работать — условия доступа и возможности инструментов важно проверять отдельно.
При этом Google и OpenAI заключили с Reddit соглашения о доступе к контенту. В частности, OpenAI объявила о доступе к Reddit Data API для использования актуальных публикаций в ChatGPT и других продуктах [9].
Стратегический эффект присутствия:
Присутствие бренда в живых, ранжирующихся обсуждениях помогает покупателям находить реальный опыт пользователей. Исследование Ahrefs также обнаружило связь между упоминаниями в таких ветках и AI-видимостью брендов. Поэтому стоит следить за релевантными обсуждениями и участвовать в них по правилам сообществ.
3. На кого ссылается ChatGPT: издатели и медиапартнёры OpenAI
С 2023 года OpenAI заключила соглашения с более чем 20 издательскими холдингами и организациями, включая Condé Nast, Hearst, Future plc, Axel Springer, Vox Media и Financial Times [2]. В зависимости от условий сотрудничества ChatGPT может использовать материалы изданий и ссылаться на них в ответах.
Ahrefs проследил, какое место партнёрские сайты занимают среди источников ChatGPT. В исследовании поисковых подзапросов их доля цитат среди 200 наиболее цитируемых доменов выросла с 7,5% в марте 2026 года до 15,8% в июле, а к концу сентября составила 12,5% [2].
Какие издания цитируются чаще?
Ahrefs проверил 85 партнёрских доменов: 10 вошли в топ-50 наиболее цитируемых сайтов, а 47 — в топ-500. Среди них издания разных тематик:
| Издание | Тематика | Место среди цитируемых сайтов |
|---|---|---|
| Tom’s Guide | Технологии и обзоры | 15 |
| Car and Driver | Автомобили | 18 |
| TechRadar | Технологии и обзоры | 24 |
| Wired | Технологии и наука | 34 |
| The Guardian | Новости и аналитика | 50 |
Данные Ahrefs Brand Radar относятся к ответам ChatGPT для пользователей в США. В выборке заметное место занимают не только новостные издания, но и сайты с обзорами, сравнениями и практическими рекомендациями.
При этом частота цитирования отдельных изданий сильно различается даже внутри одного холдинга. Например, Business Insider получил 16 415 цитирований, а Politico — 10, хотя оба входят в Axel Springer.
Что с этим делать бренду?
Допустим, вы продаёте CRM-систему. Спросите у ChatGPT: «Какую CRM выбрать для небольшой компании?» Посмотрите, на какие обзоры и сравнения он ссылается. Если вашего продукта в этих материалах нет, можно связаться с редакцией издания или автором обзора и предложить им протестировать продукт.
Повторяйте такую проверку регулярно: источники в ответах меняются. Но найти подходящее издание — только часть задачи. Важно ещё понять, что именно увидит пользователь в ответе ChatGPT: название вашей CRM, ссылку на ваш сайт или что-то одно из двух.
4. Бренд, ссылки и клики: что происходит в AI-ответах
Вернёмся к примеру с CRM. ChatGPT может назвать ваш продукт в ответе, но не дать ссылку на сайт. Или наоборот: сослаться на страницу вашего сайта, не упомянув название компании в тексте.
Допустим, человек увидел название вашей CRM в ответе, запомнил его и позже вернулся к выбору продукта. В Google Analytics вы не увидите это упоминание — аналитика покажет переходы на сайт, а не всё, что пользователь прочитал в ChatGPT.
Получается, одних переходов недостаточно: важно следить и за тем, на какие сайты ссылается нейросеть, и за тем, какие бренды она называет.
Насколько часто ссылка и упоминание расходятся? Это выясняли Semrush и Кевин Индиг в исследовании The Ghost Citations Study [4].
Исследователи проанализировали 3 981 появление доменов и брендов по 115 коммерческим и информационным промптам в 14 странах на четырёх AI-платформах (ChatGPT, Google AI Overviews, Google AI Mode, Gemini).
Результаты разделили на три случая: ссылка на сайт без названия бренда, название бренда без ссылки и сочетание обоих вариантов. Первый случай исследователи называют «призрачной цитатой» (Ghost Citation): страница есть в источниках, но бренд не назван в тексте ответа.
Как бренды и сайты появляются в AI-ответах:
Доли рассчитаны от всех зафиксированных появлений бренда или его сайта.
| Тип появления бренда или сайта | Доля в исследовании |
|---|---|
| Призрачная цитата: ссылка на сайт есть, бренд не назван | 61,7% |
| Бренд назван в тексте, но ссылки на его сайт нет | 25,1% |
| Бренд назван в тексте и есть ссылка на его сайт | 13,2% |
При этом поведение систем принципиально различается в зависимости от платформы:
- В ChatGPT (среди зафиксированных появлений бренда/домена) в 87% случаев ставится ссылка на первоисточник со сноской, но название бренда встречается в тексте лишь в 20,7% случаев. Модель форматирует ответ по принципу академической статьи с библиографией.
- В Google AI Mode ситуация иная: бренд упоминается в тексте почти в два раза чаще, чем в ChatGPT, однако значительная часть ссылок распределяется среди сторонних агрегаторов, медиа и каталогов.
От упоминания — к выбору продукта
Нейросеть может назвать ваш продукт в ответе покупателю, даже не поставив ссылку на ваш сайт. Человек прочитает сравнение, запомнит название и позже найдёт продукт в Google. А может пока просто включить его в список вариантов.
Поэтому упоминания без ссылки тоже стоит отслеживать: они показывают, что бренд появляется перед потенциальными покупателями, даже когда переходов из ответа нет.
С товарами история становится ещё интереснее: ChatGPT может не просто назвать бренд, а показать конкретные модели с фотографиями и ценами. Для магазина это уже вопрос не только узнаваемости, но и присутствия товара в подборке в момент выбора.
5. ChatGPT Shopping: как товары попадают в рекомендации и при чём здесь Google
Покупатель просит ChatGPT подобрать ноутбук для работы или кофемашину для дома — и получает подборку прямо в чате. В карточках могут быть фотографии, цены, краткие описания, пометки вроде «бюджетный вариант» и краткое содержание отзывов.
При этом сам формат покупок в ChatGPT изменился. В марте 2026 года OpenAI отошла от ранней модели Instant Checkout, которая позволяла оформлять покупку внутри чата, и сосредоточилась на поиске и выборе товаров. Покупку пользователь оформляет у продавца [5].
Для магазинов и производителей это означает новый вопрос: что помогает товару попасть в подборку, когда покупатель выбирает между несколькими вариантами? Прежде чем разбирать источники товарных данных, посмотрим, какие бренды пользователи ChatGPT встречают чаще всего.
Ahrefs проанализировал 5,5 млн ответов ChatGPT в США по разным темам. Торговые сети и платформы заняли 6 из 10 первых мест среди наиболее упоминаемых брендов [3]:
- Walmart: 95 605 упоминаний (1,73% от всех 5,5 млн ответов).
- Target: 52 096 упоминаний (0,94%).
- Apple: 45 297 упоминаний (0,82%).
- Amazon: 38 795 упоминаний (0,70%).
- The Home Depot: 34 876 упоминаний (0,63%).
В выборке Ahrefs ритейлеры часто упоминались в ответах, в том числе на вопросы о покупках и выборе товаров. Но откуда ChatGPT берёт конкретные товары для своих подборок?
Google Shopping как источник товаров для ChatGPT
В исследовании Peec AI, опубликованном в Search Engine Land в марте 2026 года, обнаружили не только пересечение товаров. Исследователи декодировали поле id_to_token_map из данных каруселей ChatGPT: в нём обнаружились идентификаторы товаров и предложений (productid, offerid), из которых удалось восстановить ссылки Google Shopping на те же товары [14].
Затем они сравнили около 43 000 товаров из 5 000 каруселей ChatGPT с первыми 40 органическими результатами Google Shopping и Bing Shopping по соответствующим товарным подзапросам. Исследование охватило 10 товарных категорий; рекламные позиции исключили.
Более 83% товаров из каруселей ChatGPT нашли в топ-40 Google Shopping. Для Bing Shopping показатель составил около 11%.
Совпадения определяли по сходству названий и брендов, учитывая различия в формулировках. При этом 60% сильных совпадений приходились на топ-10 Google Shopping, а почти 84% — на топ-20. По выводу авторов, Google Shopping служил основным источником товаров для изученных каруселей, а товары с высоких позиций чаще появлялись ближе к началу подборки ChatGPT.
Ранее эксперимент Semrush показал похожую картину: товар, рекомендованный ChatGPT первым, в 75,5% случаев входил в топ-3 органических результатов Google Shopping [15].
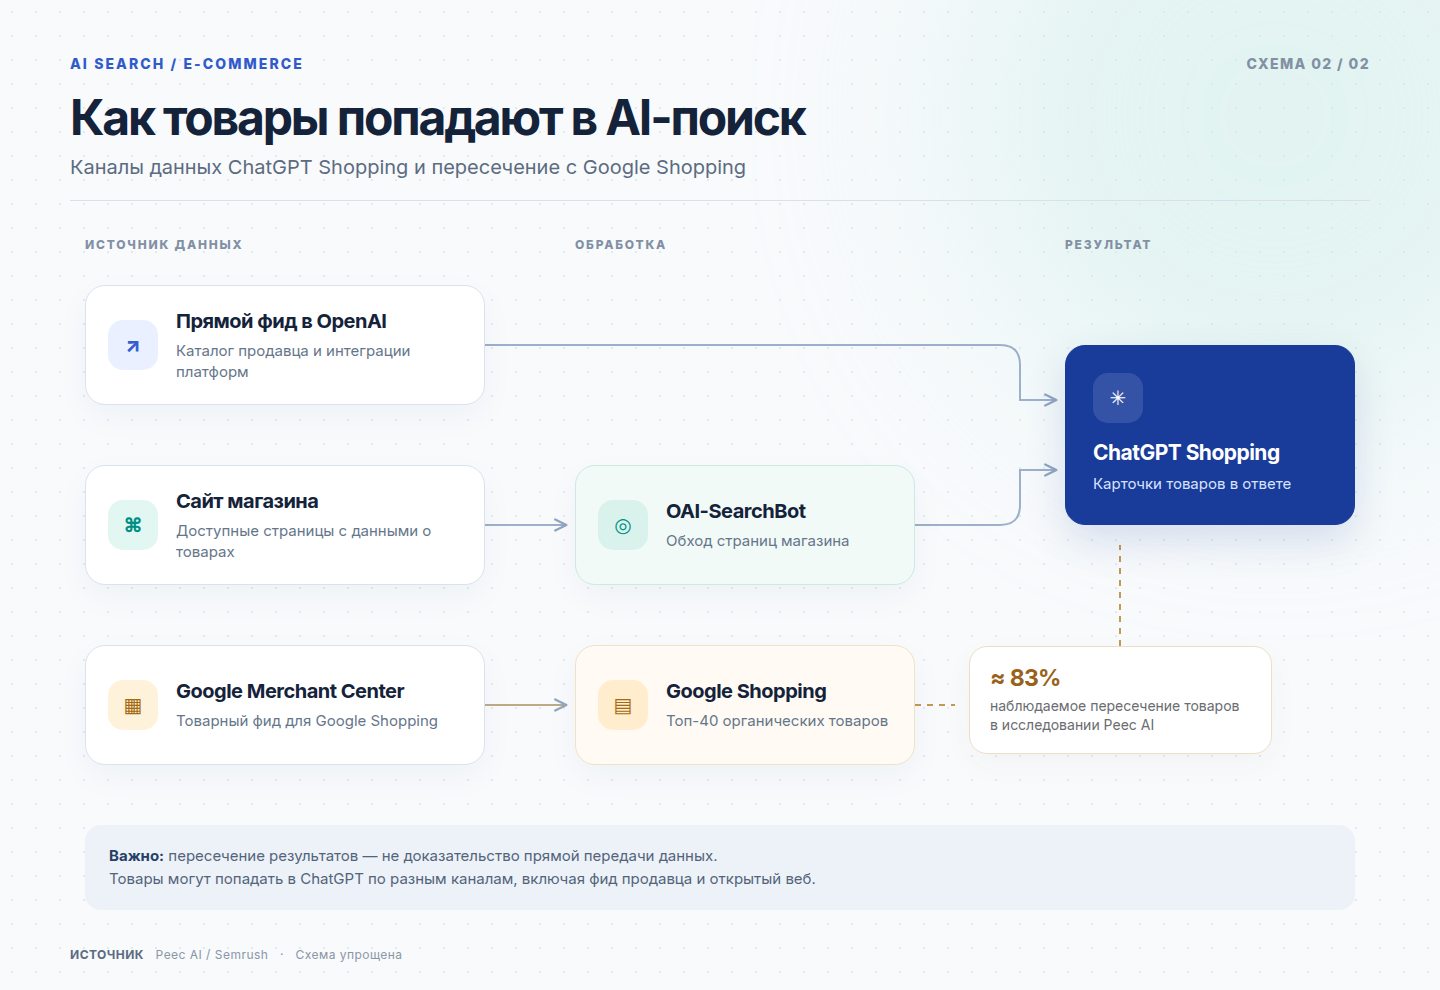
Откуда ChatGPT получает данные о товарах?
Исследование Peec AI описывает работу каруселей в изученный период. Помимо Google Shopping, в документации OpenAI указаны и другие источники товарных данных:
- Товарный фид OpenAI. Продавец может подать заявку на передачу каталога напрямую в ChatGPT. Фид помогает передавать цены, наличие и другие характеристики. OpenAI также сообщает, что каталоги Shopify и Etsy уже интегрированы [11].
- Сайт магазина. OpenAI прямо указывает, что товарный фид не обязателен, если ChatGPT уже сканирует сайт [11]. Для доступности страниц в поиске ChatGPT компания рекомендует разрешить доступ краулеру
OAI-SearchBot[16]. - Другие источники. ChatGPT также использует данные сторонних провайдеров и информацию из публичных источников — например, обзоры и отзывы. Эти сведения могут дополнять данные продавца [12].
Что делать интернет-магазину?
Работайте над органической видимостью товаров в Google Shopping — не только ради переходов из Google, но и ради присутствия в подборках ChatGPT. Это главный практический вывод исследования Peec AI.
Проверьте, доступны ли страницы товаров поисковому краулеру OpenAI и видны ли на них цены, наличие и характеристики. Следите, чтобы данные на сайте и в каталогах совпадали. Если планируете передавать фид напрямую, требования к нему описаны в документации OpenAI [13].
А затем регулярно проверяйте, какие товары появляются в ответах на запросы ваших покупателей — ваши или конкурентов.
6. Как организовать работу с AI-видимостью
Выше мы разобрали, где нейросети находят информацию о брендах и товарах. Теперь перейдём к практике: какие запросы проверять, что подготовить на сайте и как наладить регулярный мониторинг.
Этап 1. Соберите запросы ваших покупателей
Начните с вопросов, которые люди задают при выборе продукта. Возьмите их из переписки с клиентами, разговоров с отделом продаж и поисковых запросов. Важно проверить не только название бренда, но и ситуации, в которых покупатель пока не знает о вас.
Semrush предлагает разделить запросы для мониторинга на три группы [6]:
- Основные — для регулярного сравнения. Например: «Какую CRM выбрать для логистической компании?» или «Какие есть альтернативы HubSpot?». Проверяйте их на постоянной основе, чтобы видеть, как меняется присутствие вашего бренда и конкурентов.
- Новые — для поиска возможностей. Добавляйте вопросы клиентов и проверяйте новые сценарии: «CRM для небольшой команды без штатного администратора». Это поможет находить темы, которые не охватывает основной список.
- Проверочные — для проверки устойчивости результатов. Повторяйте важные запросы и сравнивайте ответы на других AI-платформах. Это поможет понять, действительно ли изменилось присутствие бренда или вам попался один необычный ответ.
Не заполняйте список десятками перестановок одних и тех же слов. Лучше добавляйте значимые условия выбора: бюджет, размер компании, отрасль или конкретную задачу.
Этап 2. Проверьте доступ поисковых роботов к сайту
Прежде чем работать над присутствием в AI-ответах, проверьте, могут ли поисковые роботы открыть нужные страницы. Попросите технического специалиста проверить robots.txt, настройки защиты сайта и доступ с IP-адресов роботов.
Для поиска ChatGPT важен OAI-SearchBot, для Perplexity — PerplexityBot. Если сайт блокирует их запросы, одного разрешения в robots.txt недостаточно.
Доступ для поиска и разрешение на обучение — отдельные настройки. Например, можно разрешить OAI-SearchBot, но запретить GPTBot, который собирает материалы для обучения моделей [16].
Пример настроек в robots.txt:
# Разрешить доступ краулерам AI-поисковиков
User-agent: OAI-SearchBot
Allow: /

User-agent: PerplexityBot
Allow: /

# Запретить использование контента для обучения OpenAI
User-agent: GPTBot
Disallow: /
Этап 3. Найдите обсуждения и материалы о вашей категории
Исследование Ahrefs показало сильную связь между упоминаниями в ранжирующихся ветках Reddit и AI-видимостью. На практике это повод посмотреть, где покупатели уже обсуждают вашу категорию и конкурентов.
- Найдите подходящие обсуждения. Проверьте, какие ветки Reddit появляются в Google по вашим запросам. Начать можно с первой десятки результатов.
- Подключите специалистов компании. Пусть в обсуждениях участвуют люди, которые могут ответить на вопросы, привести реальные примеры и объяснить различия между продуктами. Учитывайте правила сообщества и открыто обозначайте связь с компанией.
- Проверьте субтитры на YouTube. В обзорах и инструкциях должны правильно передаваться названия продуктов, характеристики и пояснения. Это делает содержание видео понятнее и зрителям, и системам, которые работают с его текстом.
Этап 4. Настройте регулярный сбор в A-Parser
Несколько запросов можно проверить вручную. Когда список растёт и нужно сравнивать ответы за разные даты, удобнее автоматизировать сбор. Можно использовать готовый сервис мониторинга или настроить собственный сбор в A-Parser.
Сравнение моделей организации регулярного AI-мониторинга:
| Критерий | Облачные SaaS-платформы | Свой сбор данных в A-Parser |
|---|---|---|
| Оплата | Обычно подписка с лимитами по тарифу | Бессрочная лицензия; прокси и инфраструктура оплачиваются отдельно |
| Увеличение объёма проверок | Может потребовать перехода на более дорогой тариф | Нет отдельной платы A-Parser за запросы; расходы зависят от ресурсов и трафика |
| Результаты | Готовые отчёты; доступ к исходным данным зависит от сервиса | Тексты ответов и ссылки для собственного анализа |
| Настройка и поддержка | Большую часть технических задач берёт на себя сервис | Настройка сбора, прокси и обработка результатов — на вашей стороне |
Встроенные парсеры A-Parser для мониторинга
Для этой задачи в A-Parser есть встроенные парсеры поисковой выдачи, AI-ответов и обсуждений Reddit:
 SE::Google и
 SE::Google::Modern — AI Overviews и товарные карусели:
- Встроенные парсеры собирают не только стандартные ссылки поисковой выдачи, но и блок ИИ-ответа (AI Overview): текст ответа, тип блока, интерактивные сниппеты, список ссылок на первоисточники и их анкоры.
- Также собирают блоки People Also Ask и товарные карусели Google Shopping. Это позволяет сопоставлять товары в Google с подборками ChatGPT.
 FreeAI::ChatGPT — прямой сбор ответов ChatGPT:
- Собирает текст ответов веб-версии ChatGPT и ссылки на источники без оплаты токенов. По этим данным можно проверить, какие бренды названы и в каком контексте.
 FreeAI::GoogleAI — отслеживание Google AI Mode:
- Собирает текст ответа Google AI Mode и ссылки на источники с анкорами, чтобы видеть, какие бренды названы и на какие сайты ссылается ответ.
 FreeAI::Perplexity — мониторинг ответов Perplexity:
- Собирает текст ответа, цитируемые источники и связанные вопросы (Related Questions).
 Reddit::Posts и
 Reddit::Comments — обсуждения на Reddit:
- Собирают посты и комментарии по ключевым фразам, чтобы отслеживать обсуждения вашего продукта и конкурентов. Позиции веток в Google можно проверять поисковыми парсерами.
До конца ноября 2026 года действует акция: по промокоду FESTIVAL11 — скидка 30% на бессрочные лицензии A-Parser для новых пользователей и пакеты резидентских прокси Premium Mix. Промокод можно применить на странице покупки A-Parser и в разделе Premium Mix. Подробности — в официальной теме акции [10].
От сбора данных — к отчёту
Загрузите список запросов, настройте парсеры и прокси — и собирайте ответы AI-поиска вместе со ссылками на источники. Результаты можно выгрузить в таблицу для дальнейшего анализа: какие бренды упоминаются, какие сайты цитируются и как ответы меняются со временем.
Заключение
Покупатель может впервые узнать о вашем продукте не на сайте и не в поисковой выдаче, а в ответе нейросети. Причём бренд может быть назван без ссылки — такое упоминание не отразится в отчёте о переходах, но человек увидит название и сможет вернуться к нему позже.
Поэтому работа с AI-видимостью не ограничивается собственным сайтом. Важно понимать, что о продукте пишут в обзорах и обсуждениях, какие источники цитируются по запросам покупателей и какие товары попадают в подборки.
Начните со списка вопросов вашей аудитории и регулярно проверяйте ответы: есть ли в них ваш бренд, что о нём говорят и кого предлагают вместо него. Так вы увидите, где стоит уточнить информацию на сайте, связаться с автором обзора или разобраться, почему в рекомендациях появляется конкурент.
Источники данных и библиография
- Ahrefs Research (ноябрь 2026): Louise Linehan. Which Types of Mentions Correlate the Strongest With AI Visibility? (260M AI Prompts Analyzed)
- Ahrefs Research (ноябрь 2026): Ryan Law. Every OpenAI Publisher Partnership, and How Often ChatGPT Cites Them
- Ahrefs Research (ноябрь 2026): Si Quan Ong. The 100 Most Mentioned Brands in ChatGPT (November 2026)
- Semrush (9 июня 2026): Margarita Loktionova. Why 62% of AI Citations Don’t Lead to Brand Mentions
- Semrush (ноябрь 2026): Zach Paruch. How to Optimize for ChatGPT Shopping
- Semrush (ноябрь 2026): Carlos Silva. Prompt Tracking Methodology to Measure AI Visibility
- Reddit: Continuing our infrastructure updates
- The Data Collector (10 июня 2026): What Changed in Web Data: May 2026 Recap
- OpenAI и Reddit (май 2024): OpenAI and Reddit Partnership
- A-Parser: Условия акции 11.11 на лицензии и прокси Premium Mix
- OpenAI: Power product discovery in ChatGPT
- OpenAI Help Center: Shopping with ChatGPT Search
- OpenAI Developers: Submit product feeds
- Peec AI / Search Engine Land (5 марта 2026): Tom Wells. New finding: ChatGPT sources 83% of its carousel products from Google Shopping via shopping query fan-outs
- Semrush (20 января 2026): Leigh McKenzie. ChatGPT Searches Google Shopping to Create its Recommendations
- OpenAI Developers: Overview of OpenAI Crawlers
- DataForSEO (11 ноября 2026): Google SERP Features By Industry: 2026 Trends & Key Changes