 FreeAI::Alice - Scraper van AI-assistent Alice
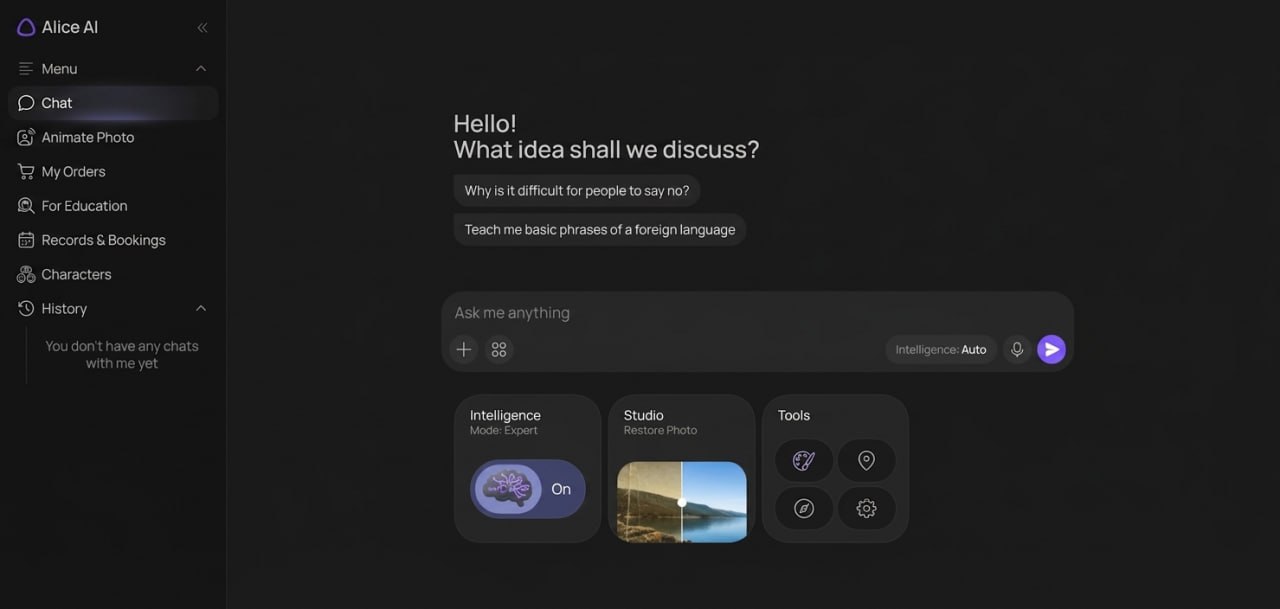
Overzicht van de scraper
De scraper Alice haalt antwoorden op van het AI-netwerk Alice via de website alice.yandex.ru en verzamelt een lijst met bronnen waarop zij zich baseert. Het resultaat bevat de antwoordtekst en bronkaarten: adres, titel en beschrijving.
Query's worden in natuurlijke taal geschreven, net als een bericht in de chat van Alice. Registratie is niet nodig: de scraper opent zelf de hoofdpagina en haalt daar de sessie-ID vandaan.
Als er binnen 2 minuten geen kant-en-klaar antwoord is ontvangen, wordt de query herhaald. Het aantal pogingen wordt bepaald door de algemene instelling Proxy retries.
Resultaten kunnen in de gewenste vorm worden opgeslagen via de sjabloon-engine Template Toolkit: tekst, CSV of JSON.
Verzamelde gegevens
- Antwoordtekst
- Links, titels en beschrijvingen van bronnen
Mogelijkheden
- Query's in natuurlijke taal
- Geavanceerde antwoordmodus
- Verzamelen van bronnen los van de antwoordtekst
Toepassingen
- Verzamelen van antwoorden op thematische query's voor kennisbanken, contentplannen en FAQ's
- Extraheren van links naar bronnen met titels en beschrijvingen
- Monitoring van onderwerpen met koppeling naar pagina's die door Alice worden aangehaald
- Snelle controle van welke websites Alice als bronnen beschouwt voor een query
Query's
Als query's wordt tekst opgegeven zoals deze in de chat van Alice zou worden getypt, bijvoorbeeld:
Wisselkoers dollar naar roebel vandaag
Kun je links geven naar nieuwe films van 2026, willekeurige films
Wat is een scraper?
Resultaten
Standaard worden de query en het antwoord weergegeven:
$query
$answer
Voorbeeld:
Kun je links geven naar nieuwe films van 2026, willekeurige films
Natuurlijk! Hier zijn enkele interessante films die in 2026 worden verwacht:

1. **Josephine** - drama, VS
2. **Wild Horse** - drama, Groot-Brittannië
3. **Spider-Man: Brand New Day** - actie, VS
...
Bronnen maken geen deel uit van deze tekst. Deze bevinden zich in de array $p1.sources.
Opties voor resultaatweergave
Antwoord en bronnen
Resultaatformaat:
ANSWER:
$p1.answer

SOURCES:
$p1.sources.format('Type:$type \n Link: $link \n $anchor \n Snippet:$snippet\n')
Voorbeeldresultaat:
ANSWER:
Natuurlijk! Hier zijn enkele interessante films die in 2026 worden verwacht:
...

SOURCES:
Type:source
 Link: https://www.film.ru/a-z/movies/2026
  Beste films van 2026
  Snippet:We hebben voor u films van 2026 verzameld op basis van beoordelingen van de auteurs van de website Film.ru
Type:source
 Link: https://www.afisha.ru/movie/y2026/
  Films en series van 2026 - Afisha-Kino
  Snippet:Films en series van 2026: kies films op genre of rating...
Export van een lijst met links
Resultaatformaat:
$p1.sources.format('$link\n')
Voorbeeldresultaat:
https://www.film.ru/a-z/movies/2026
https://www.afisha.ru/movie/y2026/
https://www.kinoafisha.info/releases/2026/
https://ru.wikipedia.org/wiki/Категория:Фильмы_2026_года
Uitvoer naar CSV van links, titels en beschrijvingen
Resultaatformaat:
[% FOREACH item IN p1.sources;
tools.CSVline(loop.count, item.link, item.anchor, item.snippet);
END %]
Voorbeeldresultaat:
1,https://www.film.ru/a-z/movies/2026,"Beste films van 2026","We hebben voor u films van 2026 verzameld op basis van beoordelingen van de auteurs van de website Film.ru"
2,https://www.afisha.ru/movie/y2026/,"Films en series van 2026 - Afisha-Kino","Films en series van 2026: kies films op genre of rating"
Geef in de bestandsnaam van de resultaten de extensie csv op.
Eén query wacht niet langer dan 2 minuten op een antwoord. Stel in de time-out van de taak een marge in die groter is dan 2 minuten vermenigvuldigd met het aantal pogingen.