 FreeAI::Alice - Scraper sieci neuronowej Alice
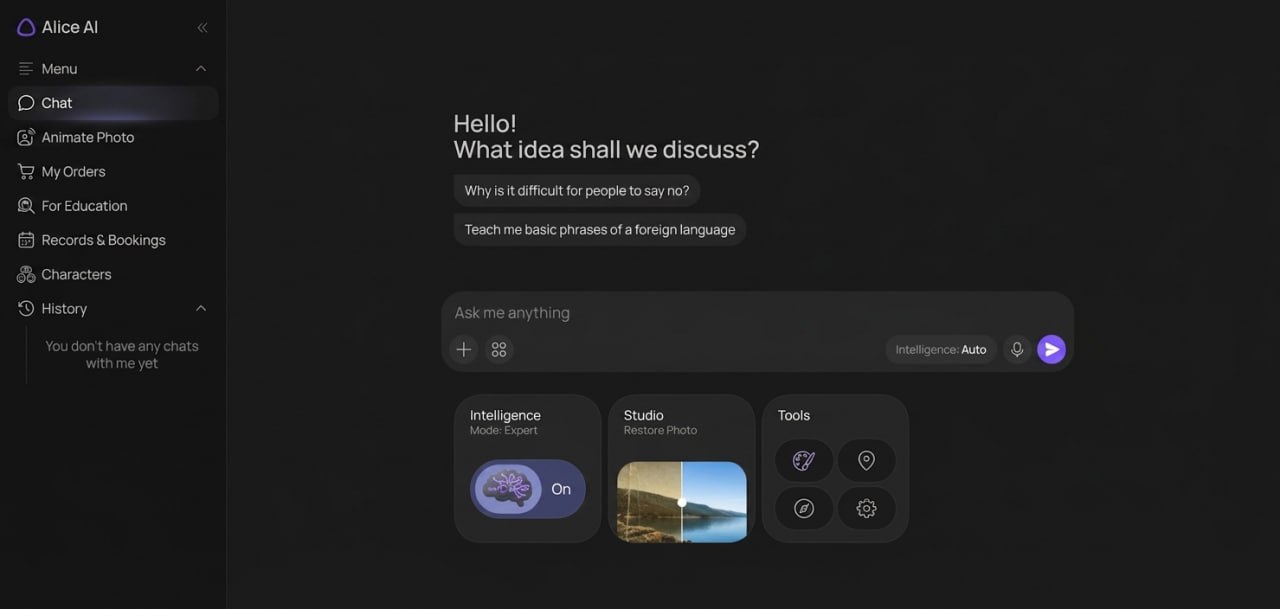
Przegląd scrapera
Scraper Alice pobiera odpowiedź sieci neuronowej Alicja ze strony alice.yandex.ru oraz listę źródeł, na których się ona opiera. Wynik zawiera tekst odpowiedzi oraz karty źródeł: adres, nagłówek i opis.
Zapytania pisze się zwykłym językiem, tak samo jak wiadomość na czacie Alicji. Rejestracja nie jest wymagana: scraper sam otwiera stronę główną i pobiera stamtąd identyfikator sesji.
Jeśli gotowa odpowiedź nie nadejdzie w ciągu 2 minut, zapytanie jest powtarzane. Liczba prób jest określana przez ogólne ustawienie Proxy retries.
Wyniki można zapisać w żądanym formacie za pomocą silnika szablonów Template Toolkit: tekst, CSV lub JSON.
Zbierane dane
- Tekst odpowiedzi
- Linki, nagłówki i opisy źródeł
Funkcje
- Zapytania w języku naturalnym
- Zaawansowany tryb odpowiedzi
- Zbieranie źródeł oddzielnie od tekstu odpowiedzi
Zastosowania
- Zbieranie odpowiedzi na zapytania tematyczne dla baz wiedzy, planów treści i FAQ
- Wyodrębnianie linków do źródeł wraz z nagłówkami i opisami
- Monitorowanie tematów z powiązaniem do stron, które podała Alicja
- Szybkie sprawdzanie, jakie strony Alicja uważa za źródła dla danego zapytania
Zapytania
Jako zapytania podaje się tekst, tak jakby był napisany na czacie Alicji, na przykład:
Kurs dolara do rubla dzisiaj
Czy możesz podać linki do nowych filmów 2026 dowolne filmy
Co to jest scraper?
Wyniki
Domyślnie wyświetlane jest zapytanie i odpowiedź:
$query
$answer
Przykład:
Czy możesz podać linki do nowych filmów 2026 dowolne filmy
Oczywiście! Oto kilka interesujących filmów, które są spodziewane w 2026 roku:

1. **Josephine (Josephine)** - dramat, USA
2. **Dziki koń (Wild Horse)** - dramat, Wielka Brytania
3. **Spider-Man: Nowy dzień (Spider-Man: Brand New Day)** - akcja, USA
...
Źródła nie są częścią tego tekstu. Znajdują się one w tablicy $p1.sources.
Warianty wyświetlania wyników
Odpowiedź i źródła
Format wyniku:
ANSWER:
$p1.answer

SOURCES:
$p1.sources.format('Type:$type \n Link: $link \n $anchor \n Snippet:$snippet\n')
Przykład wyniku:
ANSWER:
Oczywiście! Oto kilka interesujących filmów, które są spodziewane w 2026 roku:
...

SOURCES:
Type:source
 Link: https://www.film.ru/a-z/movies/2026
  Najlepsze filmy 2026 roku
  Snippet:Zebraliśmy dla Państwa filmy 2026 roku na podstawie ocen autorów strony Film.ru
Type:source
 Link: https://www.afisha.ru/movie/y2026/
  Filmy i seriale 2026 roku - Afisha-Kino
  Snippet:Filmy i seriale 2026 roku: wybieraj kino według gatunku lub rankingu...
Eksport listy linków
Format wyniku:
$p1.sources.format('$link\n')
Przykład wyniku:
https://www.film.ru/a-z/movies/2026
https://www.afisha.ru/movie/y2026/
https://www.kinoafisha.info/releases/2026/
https://ru.wikipedia.org/wiki/Категория:Фильмы_2026_года
Wynik w CSV: linki, nagłówki i opisy
Format wyniku:
[% FOREACH item IN p1.sources;
tools.CSVline(loop.count, item.link, item.anchor, item.snippet);
END %]
Przykład wyniku:
1,https://www.film.ru/a-z/movies/2026,"Najlepsze filmy 2026 roku","Zebraliśmy dla Państwa filmy 2026 roku na podstawie ocen autorów strony Film.ru"
2,https://www.afisha.ru/movie/y2026/,"Filmy i seriale 2026 roku - Afisha-Kino","Filmy i seriale 2026 roku: wybieraj kino według gatunku lub rankingu"
W nazwie pliku wyników należy podać rozszerzenie csv.
Pojedyncze zapytanie czeka na odpowiedź nie dłużej niż 2 minuty. W limicie czasu zadania (timeout) należy ustawić zapas większy niż 2 minuty pomnożone przez liczbę prób.