 FreeAI::Alice - Scraper della rete neurale Alice
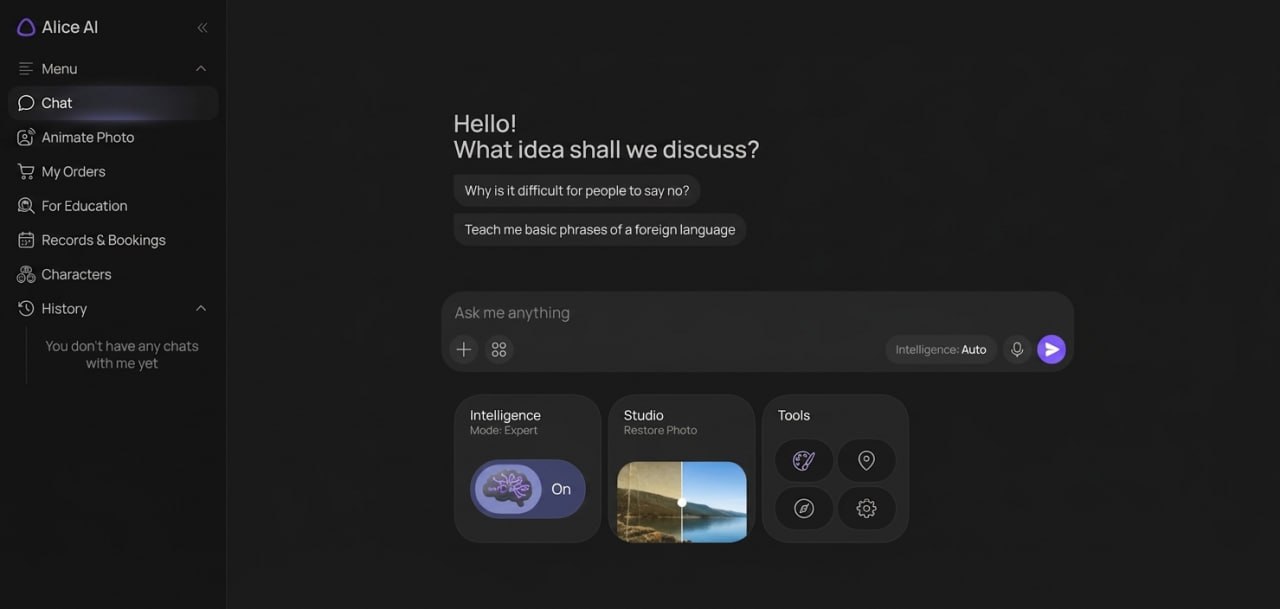
Panoramica dello scraper
Lo scraper Alice riceve la risposta dalla rete neurale Alice dal sito alice.yandex.ru e l'elenco delle fonti su cui si basa. Il risultato include il testo della risposta e le schede delle fonti: indirizzo, titolo e descrizione.
Le query vengono scritte in linguaggio naturale, proprio come un messaggio nella chat di Alice. La registrazione non è necessaria: lo scraper apre autonomamente la pagina principale e preleva da lì l'identificatore della sessione.
Se la risposta pronta non arriva entro 2 minuti, la query viene ripetuta. Il numero di tentativi è definito dall'impostazione generale Proxy retries.
I risultati possono essere salvati nel formato desiderato tramite il motore di modelli Template Toolkit: testo, CSV o JSON.
Dati raccolti
- Testo della risposta
- Link, titoli e descrizioni delle fonti
Funzionalità
- Query in linguaggio naturale
- Modalità di risposta avanzata
- Raccolta delle fonti separata dal testo della risposta
Casi d'uso
- Raccolta di risposte per query tematiche per basi di conoscenza, piani editoriali e FAQ
- Estrazione di link alle fonti con titoli e descrizioni
- Monitoraggio di argomenti con riferimento alle pagine citate da Alice
- Verifica rapida di quali siti Alice considera come fonti per una query
Query
Come query si indica il testo come se fosse scritto nella chat di Alice, ad esempio:
Tasso di cambio dollaro-rublo oggi
Puoi darmi link ai nuovi film del 2026 qualsiasi film
Cos'è uno scraper?
Risultati
Per impostazione predefinita, vengono visualizzati la query e la risposta:
$query
$answer
Esempio:
Puoi darmi link ai nuovi film del 2026 qualsiasi film
Certamente! Ecco alcuni film interessanti attesi per il 2026:

1. **Josephine (Josephine)** - drammatico, USA
2. **Wild Horse (Wild Horse)** - drammatico, Regno Unito
3. **Spider-Man: Brand New Day (Spider-Man: Brand New Day)** - azione, USA
...
Le fonti non sono incluse in questo testo. Si trovano nell'array $p1.sources.
Varianti di output dei risultati
Risposta e fonti
Formato del risultato:
ANSWER:
$p1.answer

SOURCES:
$p1.sources.format('Type:$type \n Link: $link \n $anchor \n Snippet:$snippet\n')
Esempio di risultato:
ANSWER:
Certamente! Ecco alcuni film interessanti attesi per il 2026:
...

SOURCES:
Type:source
 Link: https://www.film.ru/a-z/movies/2026
  I migliori film del 2026
  Snippet:Abbiamo raccolto per te i film del 2026 basandoci sulle valutazioni degli autori del sito Film.ru
Type:source
 Link: https://www.afisha.ru/movie/y2026/
  Film e serie TV del 2026 - Afisha-Kino
  Snippet:Film e serie TV del 2026: scegli il cinema per genere o valutazione...
Esportazione dell'elenco dei link
Formato del risultato:
$p1.sources.format('$link\n')
Esempio di risultato:
https://www.film.ru/a-z/movies/2026
https://www.afisha.ru/movie/y2026/
https://www.kinoafisha.info/releases/2026/
https://ru.wikipedia.org/wiki/Категория:Фильмы_2026_года
Output in CSV di link, titoli e descrizioni
Formato del risultato:
[% FOREACH item IN p1.sources;
tools.CSVline(loop.count, item.link, item.anchor, item.snippet);
END %]
Esempio di risultato:
1,https://www.film.ru/a-z/movies/2026,"I migliori film del 2026","Abbiamo raccolto per te i film del 2026 basandoci sulle valutazioni degli autori del sito Film.ru"
2,https://www.afisha.ru/movie/y2026/,"Film e serie TV del 2026 - Afisha-Kino","Film e serie TV del 2026: scegli il cinema per genere o valutazione"
Nel nome del file dei risultati specificare l'estensione csv.
Una singola query attende una risposta per non più di 2 minuti. Nel timeout dell'attività, impostare un margine superiore a 2 minuti moltiplicati per il numero di tentativi.