 FreeAI::Alice - Scraper de l'IA Alice
Présentation du scraper
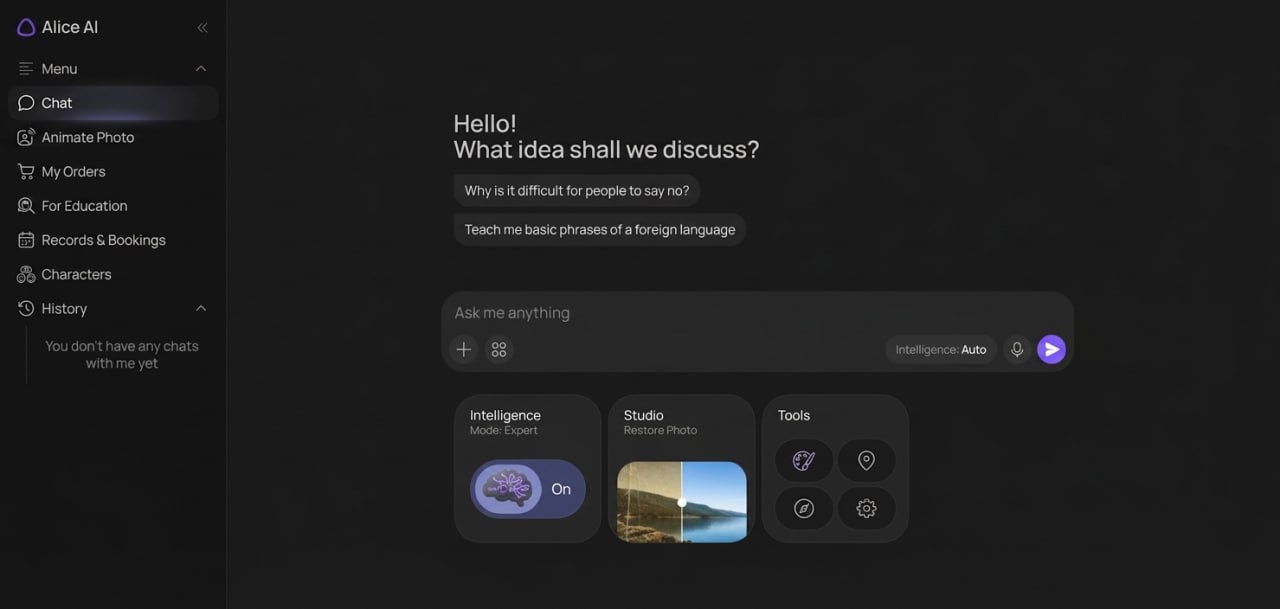
Le scraper Alice récupère la réponse de l'IA Alice sur le site alice.yandex.ru ainsi que la liste des sources sur lesquelles elle s'appuie. Le résultat inclut le texte de la réponse et les fiches des sources : adresse, titre et description.
Les requêtes sont rédigées en langage naturel, tout comme un message dans le chat d'Alice. L'inscription n'est pas nécessaire : le scraper ouvre lui-même la page d'accueil et y récupère l'identifiant de session.
Si la réponse finale n'est pas reçue dans les 2 minutes, la requête est répétée. Le nombre de tentatives est défini par le paramètre général Proxy retries.
Les résultats peuvent être sauvegardés sous la forme souhaitée via le moteur de gabarit Template Toolkit : texte, CSV ou JSON.
Données collectées
- Texte de la réponse
- Liens, titres et descriptions des sources
Fonctionnalités
- Requêtes en langage naturel
- Mode de réponse avancé
- Collecte des sources séparément du texte de la réponse
Cas d'utilisation
- Collecte de réponses sur des requêtes thématiques pour des bases de connaissances, des calendriers éditoriaux et des FAQ
- Extraction de liens vers des sources avec titres et descriptions
- Veille thématique avec lien vers les pages citées par Alice
- Vérification rapide des sites qu'Alice considère comme sources pour une requête donnée
Requêtes
Les requêtes sont indiquées sous forme de texte, comme si elles étaient écrites dans le chat d'Alice, par exemple :
Taux du dollar par rapport au rouble aujourd'hui
Peux-tu donner des liens vers de nouveaux films 2026 n'importe quels films
Qu'est-ce qu'un scraper ?
Résultats
Par défaut, la requête et la réponse sont affichées :
$query
$answer
Exemple :
Peux-tu donner des liens vers de nouveaux films 2026 n'importe quels films
Bien sûr ! Voici quelques films intéressants attendus en 2026 :

1. **Josephine (Josephine)** - drame, USA
2. **Wild Horse (Wild Horse)** - drame, Royaume-Uni
3. **Spider-Man: Brand New Day (Spider-Man: Brand New Day)** - action, USA
...
Les sources ne sont pas incluses dans ce texte. Elles se trouvent dans le tableau $p1.sources.
Variantes d'affichage des résultats
Réponse et sources
Format du résultat :
ANSWER:
$p1.answer

SOURCES:
$p1.sources.format('Type:$type \n Link: $link \n $anchor \n Snippet:$snippet\n')
Exemple de résultat :
ANSWER:
Bien sûr ! Voici quelques films intéressants attendus en 2026 :
...

SOURCES:
Type:source
 Link: https://www.film.ru/a-z/movies/2026
  Meilleurs films de 2026
  Snippet:Nous avons rassemblé pour vous les films de 2026 basés sur les notes des auteurs du site Film.ru
Type:source
 Link: https://www.afisha.ru/movie/y2026/
  Films et séries de 2026 - Afisha-Kino
  Snippet:Films et séries de 2026 : choisissez un film par genre ou par note...
Export de la liste de liens
Format du résultat :
$p1.sources.format('$link\n')
Exemple de résultat :
https://www.film.ru/a-z/movies/2026
https://www.afisha.ru/movie/y2026/
https://www.kinoafisha.info/releases/2026/
https://ru.wikipedia.org/wiki/Категория:Фильмы_2026_года
Sortie CSV des liens, titres et descriptions
Format du résultat :
[% FOREACH item IN p1.sources;
tools.CSVline(loop.count, item.link, item.anchor, item.snippet);
END %]
Exemple de résultat :
1,https://www.film.ru/a-z/movies/2026,"Meilleurs films de 2026","Nous avons rassemblé pour vous les films de 2026 basés sur les notes des auteurs du site Film.ru"
2,https://www.afisha.ru/movie/y2026/,"Films et séries de 2026 - Afisha-Kino","Films et séries de 2026 : choisissez un film par genre ou par note"
Dans le nom du fichier de résultats, indiquez l'extension csv.
Une seule requête attend une réponse pendant 2 minutes maximum. Dans le timeout de la tâche, prévoyez une marge supérieure à 2 minutes multipliées par le nombre de tentatives.