 FreeAI::Alice - Scraper da rede neural Alice
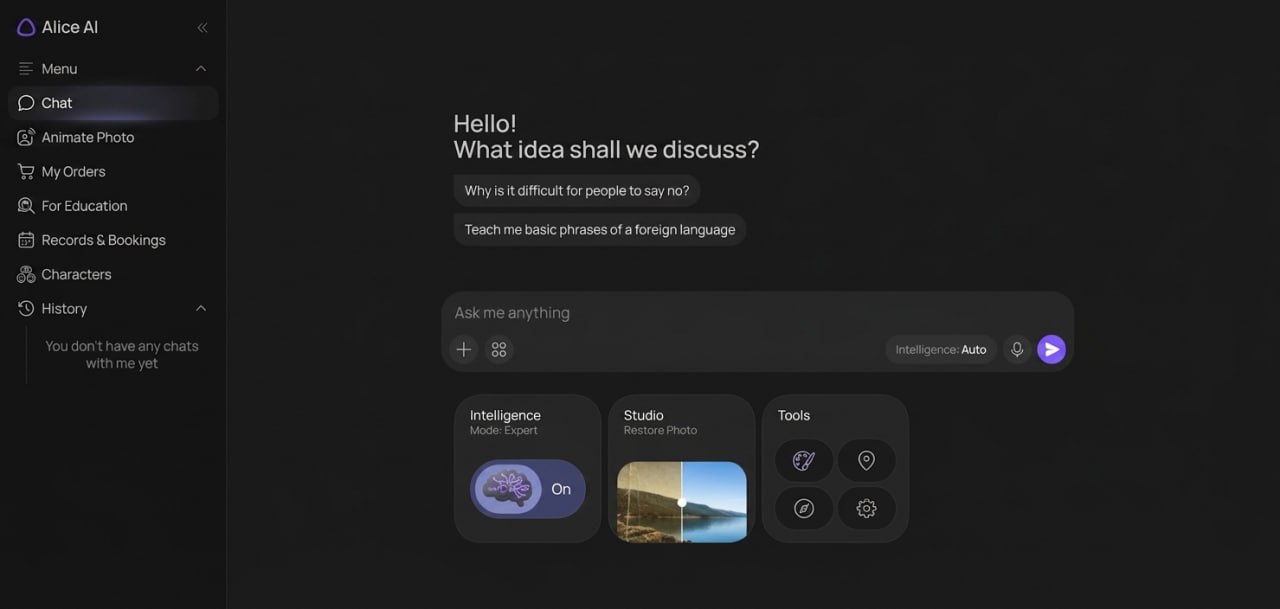
Visão geral do scraper
O scraper Alice obtém a resposta da rede neural Alice do site alice.yandex.ru e a lista de fontes nas quais ela se baseia. O resultado inclui o texto da resposta e os cartões das fontes: endereço, título e descrição.
As consultas são escritas em linguagem natural, da mesma forma que uma mensagem no chat da Alice. Não é necessário registro: o scraper abre a página inicial por conta própria e obtém o identificador da sessão de lá.
Se uma resposta pronta não chegar em 2 minutos, a consulta é repetida. O número de tentativas é definido pela configuração geral Proxy retries.
Os resultados podem ser salvos no formato desejado através do processador de modelos Template Toolkit: texto, CSV ou JSON.
Dados coletados
- Texto da resposta
- Links, títulos e descrições das fontes
Recursos
- Consultas em linguagem natural
- Modo de resposta avançado
- Coleta de fontes separadamente do texto da resposta
Casos de uso
- Coleta de respostas para consultas temáticas para bases de conhecimento, planos de conteúdo e FAQ
- Extração de links para fontes com títulos e descrições
- Monitoramento de tópicos com vínculo às páginas citadas pela Alice
- Verificação rápida de quais sites a Alice considera como fontes para uma consulta
Consultas
Como consultas, indica-se o texto como se fosse escrito no chat da Alice, por exemplo:
Taxa de câmbio do dólar para o rublo hoje
Você pode me dar links para novos filmes de 2026, quaisquer filmes
O que é um scraper?
Resultados
Por padrão, são exibidos a consulta e a resposta:
$query
$answer
Exemplo:
Você pode me dar links para novos filmes de 2026, quaisquer filmes
Claro! Aqui estão alguns filmes interessantes esperados para 2026:

1. **Josephine (Josephine)** - drama, EUA
2. **Cavalo Selvagem (Wild Horse)** - drama, Reino Unido
3. **Homem-Aranha: Um Novo Dia (Spider-Man: Brand New Day)** - ação, EUA
...
As fontes não estão incluídas neste texto. Elas estão localizadas no array $p1.sources.
Opções de exibição de resultados
Resposta e fontes
Formato do resultado:
ANSWER:
$p1.answer

SOURCES:
$p1.sources.format('Type:$type \n Link: $link \n $anchor \n Snippet:$snippet\n')
Exemplo de resultado:
ANSWER:
Claro! Aqui estão alguns filmes interessantes esperados para 2026:
...

SOURCES:
Type:source
 Link: https://www.film.ru/a-z/movies/2026
  Melhores filmes de 2026
  Snippet:Reunimos para você os filmes de 2026 com base nas avaliações dos autores do site Film.ru
Type:source
 Link: https://www.afisha.ru/movie/y2026/
  Filmes e séries de 2026 - Afisha-Kino
  Snippet:Filmes e séries de 2026: escolha o filme por gênero ou classificação...
Exportação da lista de links
Formato do resultado:
$p1.sources.format('$link\n')
Exemplo de resultado:
https://www.film.ru/a-z/movies/2026
https://www.afisha.ru/movie/y2026/
https://www.kinoafisha.info/releases/2026/
https://ru.wikipedia.org/wiki/Категория:Фильмы_2026_года
Saída em CSV de links, títulos e descrições
Formato do resultado:
[% FOREACH item IN p1.sources;
tools.CSVline(loop.count, item.link, item.anchor, item.snippet);
END %]
Exemplo de resultado:
1,https://www.film.ru/a-z/movies/2026,"Melhores filmes de 2026","Reunimos para você os filmes de 2026 com base nas avaliações dos autores do site Film.ru"
2,https://www.afisha.ru/movie/y2026/,"Filmes e séries de 2026 - Afisha-Kino","Filmes e séries de 2026: escolha o filme por gênero ou classificação"
No nome do arquivo de resultados, especifique a extensão csv.
Uma única consulta aguarda a resposta por no máximo 2 minutos. No timeout da tarefa, coloque uma margem maior que 2 minutos multiplicados pelo número de tentativas.