 SE::DuckDuckGo::Position - Verifica delle posizioni del sito per parole chiave in DuckDuckGo
Panoramica dello scraper
Scraper per il controllo delle posizioni di un sito web tramite parole chiave in DuckDuckGo. Grazie allo scraper SE::DuckDuckGo::Position potrai controllare automaticamente le posizioni nei risultati di ricerca di DuckDuckGo utilizzando i tuoi database di domini. Utilizzando lo scraper SE::DuckDuckGo::Position è possibile determinare in modo facile, accurato e veloce la posizione di un sito in DuckDuckGo.
La funzionalità di A-Parser consente di salvare le impostazioni di scraping dello scraper SE::DuckDuckGo::Position per un uso futuro (preset), impostare programmi di scraping e molto altro. È possibile utilizzare la sostituzione automatica delle sotto-query dai file.
Il salvataggio dei risultati è possibile nel formato e nella struttura necessari, grazie al potente motore di modelli integrato Template Toolkit che consente di applicare logica aggiuntiva ai risultati e di esportare i dati in vari formati, tra cui JSON, SQL e CSV.
Dati raccolti
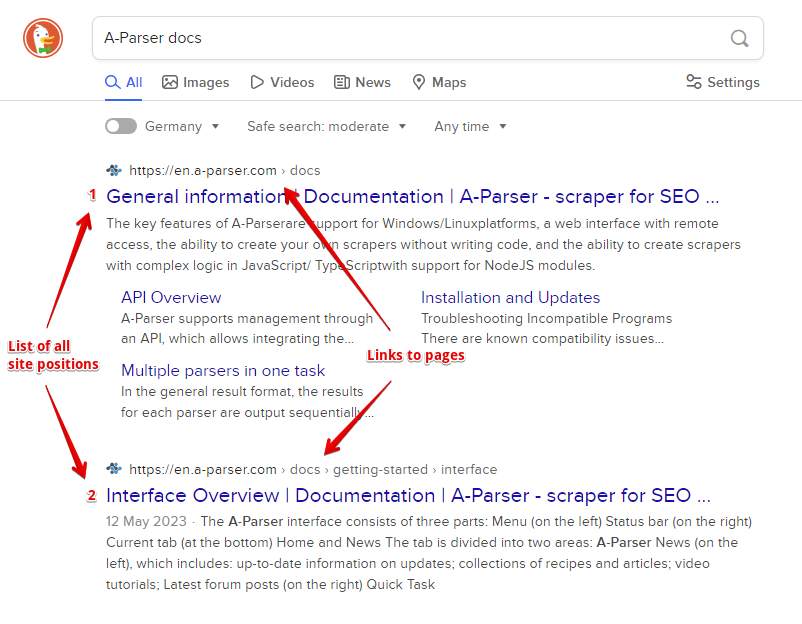
- Posizione del sito e link alla pagina del sito
- Elenco di tutte le posizioni del sito e dei link alle pagine
Funzionalità
- Tutte le funzionalità dello scraper
 SE::DuckDuckGo
- Interrompe automaticamente lo scraping quando il sito viene trovato
- Supporta la ricerca di sottodomini
- Possibilità di confrontare la posizione cercata per dominio, per dominio principale e per link completo
- Raccolta di posizioni contemporaneamente per più domini
Casi d'uso
- Controllo delle posizioni dei propri siti e di quelli dei concorrenti
- Ricerca di pagine del sito che generano traffico
Query
Come query è necessario indicare il dominio del sito cercato e la query di ricerca separati da uno spazio, ad esempio:
lenta.ru notizie
lenta.ru notizie online
ria.ru notizie
a-parser.com A-Parser
Se è necessario controllare un singolo sito per un elenco di query, è possibile indicare il dominio nel formato della query (Query format):
lenta.ru $query
Oppure utilizzare semplicemente un elenco di parole chiave. Per utilizzare più domini contemporaneamente nella query, è necessario indicare l'elenco dei domini separati da virgola e la parola chiave dopo uno spazio, ad esempio:
lenta.ru,ria.ru,notfound.com notizie lenta
I risultati saranno registrati nell'array $bulkcheck.
L'opzione Stop when found è supportata anche in questo caso; lo scraping terminerà se le posizioni sono state trovate per tutti i domini.
Sostituzioni nelle query
Puoi utilizzare le macro integrate per la sostituzione automatica delle sotto-query dai file; ad esempio, se vogliamo controllare uno o più siti rispetto a un database di chiavi, indichiamo alcuni domini principali:
ria.ru
lenta.ru
rbc.ru
yandex.ru
Nel formato delle query indichiamo la macro per la sostituzione di parole aggiuntive dal file Keywords.txt; questo metodo permette di controllare un database di siti rispetto a un database di chiavi e ottenere come risultato le posizioni:
$query {subs:Keywords}
Questa macro creerà tante query aggiuntive quante sono presenti nel file per ogni query di ricerca iniziale, il che risulterà in: [numero di query iniziali (domini)] x [numero di query nel file Keywords] = [numero totale di query] come risultato del lavoro della macro.
Varianti di output dei risultati
A-Parser supporta una formattazione flessibile dei risultati grazie al motore di modelli integrato Template Toolkit, che gli consente di produrre risultati in forma libera o strutturata, come CSV o JSON
Esportazione dell'elenco delle posizioni
Ottenimento del risultato sotto forma di:
dominio cercato - chiave: numero della posizione nei risultati
Formato del risultato:
$domain - $key: $position\n
Esempio di risultato:
lenta.ru - notizie online: 13
lenta.ru - notizie: 26
ria.ru - notizie: 1
a-parser.com - A-Parser: 1
...
Controllo simultaneo di più domini (controllo batch)
Le informazioni su tutti i domini durante il controllo simultaneo di più domini sono contenute nell'array $bulkcheck.
Formato del risultato:
$bulkcheck.format('$domain - $position\n')
Esempio di query:
lenta.ru,ria.ru,notfound.com notizie lenta
Esempio di risultato:
lenta.ru - 2
ria.ru - 6
notfound.com - 0
Link + anchor + snippet con output della posizione
Output di link, anchor e snippet in tabella CSV
Salvataggio delle parole chiave correlate
Concorrenza delle parole chiave
Controllo dell'indicizzazione dei link
Salvataggio in formato SQL
Dump dei risultati in JSON
Elaborazione dei risultati
A-Parser consente di elaborare i risultati direttamente durante lo scraping; in questa sezione abbiamo riportato i casi più popolari per lo scraper SE::DuckDuckGo::Position
Salvataggio dei domini senza posizioni zero
Come base è stato preso l'esempio del controllo simultaneo di più domini (vedi sopra nelle varianti di output dei risultati) ed è stato aggiunto un filtro.
Aggiungi un filtro e seleziona la variabile di output della posizione dal menu a discesa. Scegli il tipo: >. Successivamente, in Number (Numero), inserisci 0. Con questo filtro potrai rimuovere tutti i risultati con posizione zero.
Scarica esempio
Come importare l'esempio in A-Parser
eJx1VNtu2zAM/RVDCNAVyIJ2a4HBDwPSbhk2dE3Wy1OSB8WiWy2y6OmSXoL8+yhZ
ttNufYgi3g55SMpb5rhd25kBC86yfL5ldbyznF1/zfMvvliH3zfM8xla6STq7H12
zTeQCay41DZ7kO4evct49gwGszq5sSGrubFgAuz8TTRyE1Byrxwbbpl7qoFS4waM
kQLIKAXJ3kJt8PGJ5A1XnlxKrizs3o4o0VTcEZUI3EaxwcqrdXEPxXrUeLw7GDQ8
iNWgLX2x0AeHbA+9lMqBIZwEmM9ZBxR4tlyWw+R608R93kt9RHeso1vOLGjLdstl
i2gnsZpQYX08SiPojKHdN9jUAb16QtIlryIvwR0Ea0vrcOQeAwIXIpbGVZMhDKPP
eqvln1icRvKlq5FgJwYrUjmIAEH51FY3Z4MoB6I+xv5qYtJAhsxSqRNOhYjXFklt
4Q7NNPaA9FuGeqzUBWxA9W4R/8xLJWhzxiUFfU+B/3eZ/oOx6+jtp6L9eDBUQ4cS
pbPpzz5K4AXeEXOxIt5KVtKRbM/Ra5fmtwaou55dhp5VaKBLk5BTdnpUNeiwjP3I
xnWvekHjxVheKgvUpbybpgVvPb2+oZc71edY1QoCL+2VGoanctWvx9imMQShL/B1
8HlMEai3T5E5RGV/XDel1kbS+p2GAivq5H7WBFlwpW6vLvYtrF8pEhRox0fGD42M
fxpdSZ0VowKrbOGPTj6KeEI8P/T3k+N4NppPjesqnqd9WDKHGRX0Eu6QdpT6tFt2
H6HuE7d9+1OUb3e0Br/trAkJPQsBpKPm2+hxvPsLSinNVw==
Vedi anche: Filtri dei risultati
Deduplicazione dei link
Deduplicazione dei link per dominio
Estrazione dei domini
Rimozione dei tag da anchor e snippet
Filtrazione dei link per inclusione
Impostazioni possibili
Supporta tutte le impostazioni dello scraper SE::DuckDuckGo, oltre a quanto segue:
| Nome parametro | Valore predefinito | Descrizione |
|---|---|---|
| Result format | $domain - $key: $position\n | Formato di output predefinito del risultato |
| Stop when found | ☑ | Interrompe lo scraping se il dominio viene trovato, non passerà alle pagine successive |
| Match type | Exact domain | Possibilità di confrontare la posizione cercata per dominio, per dominio principale e per link completo (Exact domain / Top level domain / Exact url) |