 SE::Google::Position - Controllo delle posizioni del sito per parole chiave su Google
Panoramica dello scraper
Scraper per il controllo delle posizioni del sito web per parole chiave in Google. Grazie allo scraper SE::Google::Position potrai controllare automaticamente le posizioni nei risultati di ricerca di Google utilizzando i tuoi database di domini. Utilizzando lo scraper SE::Google::Position è possibile determinare in modo semplice, accurato e veloce la posizione di un sito in Google.
Le funzionalità di A-Parser consentono di salvare le impostazioni di scraping dello scraper SE::Google::Position per un uso futuro (preset), impostare pianificazioni di scraping e molto altro. È possibile utilizzare la sostituzione automatica delle sotto-query dai file.
Il salvataggio dei risultati è possibile nel formato e nella struttura necessari, grazie al potente motore di modelli integrato Template Toolkit che consente di applicare logica aggiuntiva ai risultati e di esportare i dati in vari formati, tra cui JSON, SQL e CSV.
Casi d'uso dello scraper
🔗 Lavorare con l'API, parte 1
Esempio di utilizzo dell'API di A-Parser tramite lo scraper di posizioni SE::Google::Position
🔗 Un altro esempio di utilizzo di SE::Google::Position
Determinazione della posizione del sito per parola chiave, come nel browser dell'utente
🔗 Panoramica delle opzioni di visualizzazione
L'articolo esamina 4 diverse opzioni di visualizzazione dei risultati: testo, CSV, JSON, HTML
🔗 Come scoprire le posizioni per le keyword?
Introduzione allo scraper SE::Google::Position e verifica della posizione di una parola chiave nei risultati di ricerca
Dati raccolti
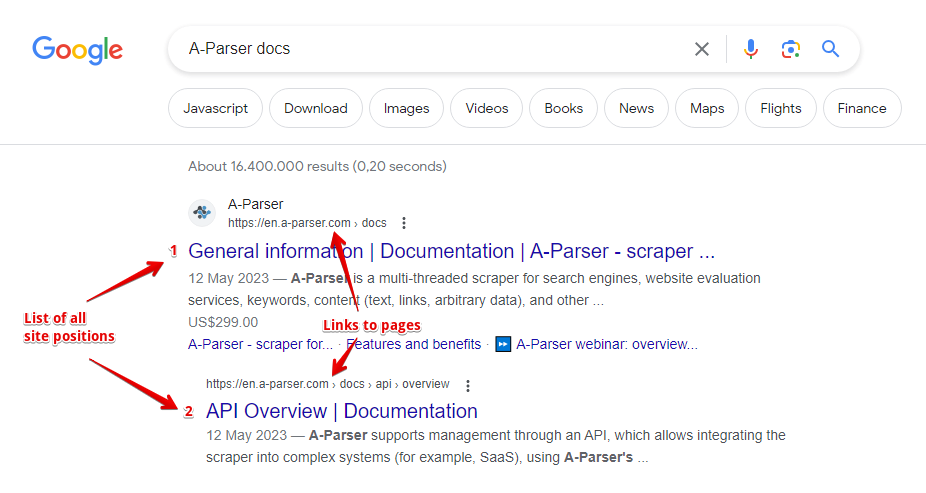
- Posizione del sito e link alla pagina del sito
- Elenco di tutte le posizioni del sito e dei link alle pagine
Funzionalità
- Tutte le funzionalità dello scraper
 SE::Google
- Interrompe automaticamente lo scraping quando il sito viene trovato
- Supporta la ricerca di sottodomini
- Possibilità di confrontare la posizione cercata per dominio, per dominio principale e per link completo
- Raccolta di posizioni per più domini contemporaneamente
Casi d'uso
- Controllo delle posizioni dei propri siti e di quelli dei concorrenti
- Ricerca di pagine del sito che generano traffico
Query
Come query è necessario indicare il dominio del sito cercato e la query di ricerca separati da uno spazio, ad esempio:
lenta.ru notizie
lenta.ru notizie online
Se è necessario controllare un singolo sito per un elenco di query, è possibile specificare il dominio nel formato della query (Query format):
lenta.ru $query
Oppure utilizzare semplicemente un elenco di parole chiave. Per utilizzare più domini contemporaneamente nella query, è necessario indicare l'elenco dei domini separati da virgola e la parola chiave dopo uno spazio, ad esempio:
lenta.ru,ria.ru,notfound.com notizie feed
I risultati verranno registrati nell'array $bulkcheck.
L'opzione Stop when found è supportata anche in questo caso: lo scraping terminerà se le posizioni sono state trovate per tutti i domini.
Sostituzioni nelle query
È possibile utilizzare le macro integrate per la sostituzione automatica delle sotto-query dai file; ad esempio, se vogliamo controllare uno o più siti rispetto a un database di chiavi, indichiamo alcune query principali:
ria.ru
lenta.ru
rbc.ru
yandex.ru
Nel formato delle query indichiamo la macro di sostituzione di parole aggiuntive dal file Keywords.txt; questo metodo permette di controllare un database di siti rispetto a un database di chiavi e ottenere come risultato le posizioni:
$query {subs:Keywords}
Questa macro creerà tante query aggiuntive quante sono presenti nel file per ogni query di ricerca iniziale, il che risulterà in: [numero di query iniziali (domini)] x [numero di query nel file Keywords] = [numero totale di query] come risultato del lavoro della macro.
Esempi di output dei risultati
A-Parser supporta la formattazione flessibile dei risultati grazie al motore di modelli integrato Template Toolkit, che gli consente di produrre risultati in forma libera o strutturata, come CSV o JSON.
Esportazione dell'elenco delle posizioni
Ottenimento del risultato nel formato:
dominio cercato - chiave: numero di posizione nei risultati
Formato del risultato:
$domain - $key: $position\n
Esempio di risultato:
lenta.ru - notizie: 6
lenta.ru - notizie online: 7
...
Controllo simultaneo di più domini (controllo batch)
Le informazioni su tutti i domini durante il controllo simultaneo di più domini sono contenute nell'array $bulkcheck.
Formato del risultato:
$bulkcheck.format('$domain - $position\n')
Esempio di query:
lenta.ru,ria.ru,notfound.com notizie feed
Esempio di risultato:
lenta.ru - 1
ria.ru - 3
notfound.com - 0
Link + anchor + snippet con output della posizione
Output di link, anchor e snippet in una tabella CSV
Salvataggio delle parole chiave correlate
Concorrenza delle parole chiave
Controllo dell'indicizzazione dei link
Salvataggio in formato SQL
Dump dei risultati in JSON
Elaborazione dei risultati
A-Parser consente di elaborare i risultati direttamente durante lo scraping; in questa sezione abbiamo riportato i casi più popolari per lo scraper SE::Google::Position.
Salvataggio dei domini senza posizioni zero
Come base è stato preso l'esempio del controllo simultaneo di più domini (vedi sopra nelle opzioni di output) ed è stato aggiunto un filtro.
Aggiungere un filtro e selezionare dal menu a discesa la variabile di output della posizione. Selezionare il tipo: >. Successivamente, in Number (Numero), inserire 0. Con questo filtro potrai rimuovere tutti i risultati con posizione zero.
Scarica esempio
Come importare l'esempio in A-Parser
eJx1VNtu2zAM/RVDCNAVyIJ2a4HBDwPSYhk2ZE3Wy1OaB9WiUy2y6Ely2szwv4+S
ZTvtuhdZJA/Jw4tcM8ft1i4NWHCWpaualeHOUnbzJU2/Im4UpOkSrXQSdfI+ueE7
SAQWXGqbPEn3iJVLePIHDCZlhLExK7mxYHzI1ZuRCCIg55VybFwzty+BUuIOjJEC
yCgFyTmagjsiFGBsx1XlYaOHSm2zR8i2kxbx7mjUMiJ+o47E/b0+OmbN/6NXFkqD
z/shcs6VhQOPXCoHhuyRQrpifWpfY1fLehyht63f5wOyJ3THMsBSZkFb1qzXXUQ7
C/x9TeXpJLa+N/pW32LLAwb1jKQrXoROCO7AW7tGHE/cs4/AhQjUuGoz+EEMWe+0
/B3IaSQsXY0EOzNYkMpBCOCV+47dio2C7Autgu/P1ie2bMwsUZ1xIiJeWyS1hTs0
i9AD0tcM9VSpOexADbAQ/6KSStDWTHNy+hYd34Ys/onR9OUdpqKZPxni0EcJ0sXi
x+AlcI4bqlw8UN1KFtKRbC+x0i7ObwtQ9j278j0r0ECfJkaO2ekxlaD9gg0jm5aD
6kUZL8byUpmhzuVmEZe2Q1b6ll7sQl9iUSrwdelKqbFf5uthPaY2jsELA8HXzpch
hS+9e4rMISr7/aalWhpJ63fuCRbUycOsMWTGlbq7nh9a2LBSJCjQjk9MNTYyfDS6
nDorJhkWyX11cvZRhBPC+WG4n52Gs9V8aqEP4Twf3KLZzyijl7BB2lHqU7Puf0D9
r61++zeU1g2twC+7bOG+Xx5MOmq8DYjT5i+HCcki
Vedi anche: Filtri dei risultati
Deduplicazione dei link
Deduplicazione dei link per dominio
Estrazione dei domini
Rimozione dei tag da anchor e snippet
Filtrazione dei link per inclusione
Impostazioni possibili
Supporta tutte le impostazioni dello scraper SE::Google, oltre a:
| Nome parametro | Valore predefinito | Descrizione |
|---|---|---|
| Pages count | 1 | Numero di pagine di scraping dei risultati (da 1 a 10) |
| Result format | $domain - $key: $position\n | Formato di output predefinito del risultato |
| Stop when found | ☑ | Interrompe lo scraping se il dominio viene trovato, non passerà alle pagine successive |
| Match type | Exact domain | Possibilità di confrontare la posizione cercata per dominio, per dominio principale e per link completo (Exact domain / Top level domain / Exact url) |